我喜歡 Rust 已經很久了。它的優點很明顯,缺點也同樣明顯:無須垃圾回收即可確保記憶體安全、零成本抽象、並行安全、幾乎是現階段最好的工具鏈及周邊生態、涵蓋範圍極廣(上至雲端網路伺服器,下至微控制器),而且錯誤處理設計得非常好。至於缺點,學習曲線陡峭?所有權、借用之類的模型約束難以理解?寫起來很慢?
長久以來,我們都認為這些是 Rust 的缺點,但實際上,前兩者都可以透過訓練思維與認知來解決,唯獨緩慢的編譯速度一直拖累著我的工作流程。早幾年,這一切似乎還好;在 AI 席捲而來之前,我最不缺的就是耐心,常常為了一個演算法或一項功能寫到凌晨。可現在呢?我很難說自己沒有改變:我開始變得毫無耐心,一點也不想思考 Rust 程式碼該怎麼寫,一刻也等不了 Cargo 那漫長的進度列,尤其到了 ld 階段,連進度都沒有,每次就那樣乾卡著,實在令人難受。
這一切難道就沒有辦法解決嗎?其實是有的。大約一個月前,我嘗試了一些方法來加快 Rust 開發流程,包括最佳化工作流程等,但實際上等待時間幾乎都卡在 Cargo 上。如果不能解決這個問題,其他方法都只是治標不治本。因此,我正好藉這個機會簡單談談 Rust 開發中的 Cargo.toml 設定調校,以及相關的周邊設定。
後端理論
在 Rust 的設計中,雖然 LLVM 在某些地方顯得稍嫌懶散,但它的選擇相當恰當。不同於 Go 必須自行維護從程式碼到機器碼的整個過程,Rust 讓龐大的 LLVM 生態系統負責成熟的最佳化,這其實是很好的做法。Rust 的整體編譯流程大致可以說是:原始碼先經過詞法分析與語法分析,產生抽象語法樹(AST),接著進行巨集展開與 HIR 降級平坦化。之後進入一般的類型檢查以及少量的借用檢查,最終生成中間表示(MIR)。在此之前,所有工作皆由 Rust 編譯器自己的前端完成。
至於 MIR 之後的處理,則交由 LLVM 完成,例如將 MIR 轉換為 LLVM IR,接著 LLVM 執行其一系列優化 Pass(等級從 O0 到 O3 不等),最終產生目標平台的機器碼,並交給鏈接器組合成可執行的二進位檔案
那麼問題究竟出在哪裡呢?答案其實很簡單:LLVM 是一套非常重型的基礎設施,而這種重量級設計在生產環境中是合理的;以編譯時間換取執行時間是一種很好的理念。它銜接著上層的 Rust、C、C++、Swift 等眾多語言。這意味著它的最佳化管線是為「產生最佳機器碼」而設計的,而不是為「快速完成編譯」而設計的。在 release 模式下跑完那幾十個最佳化階段非常耗時;即使是 debug 模式下的 O0,LLVM 仍然必須走完整個中間表示產生與機器碼產生流程,而這個流程本身就不輕量。再加上 Rust 的泛型單態化會在編譯期間展開大量程式碼,交給 LLVM 的中間表示規模遠比原始碼看起來大得多,因此 LLVM 必須處理的工作量自然也會隨之膨脹。
Cranelift
所以本質上,編譯慢的時間有很大一部分並不花在 Rust 自己的前端,而是花在 LLVM 這個「重型後端」上。那麼問題來了:有沒有可能把它丟掉? 有一個叫 Cranelift 的後端,就是為了這個需求做的。它最早叫 Cretonne,2016 年啟動,由 Bytecode Alliance 開發,一開始就是,Wasmtime 專用的程式碼生成後端;後來被 Rust 官方收編,成為可選的 codegen 後端。


所以 Cranelift 到底應該快在哪裡呢?最適合它發揮優勢的階段就是開發期。此時你也許根本不需要接近完美、將執行效率最佳化到極限的機器碼,也許我們需要的只是快速回饋;只要這份不那麼出色的機器碼與 LLVM 正式產生的機器碼在語意上等價就夠了。早期的 Cranelift 其實做不到這一點,因為存在許多邊界情況;雖然現在依然有,但已經改善許多,如今遇到 Cranelift 可以執行而 LLVM 出錯的機率,已經和你寫 Rust 時觸發 rustc 內部編譯器錯誤的機率差不多了。為了產生極致最佳化的機器碼,LLVM 會執行幾十輪最佳化,例如迴圈展開、向量化、常數傳播、移除無用程式碼等……還有許許多多,一層一層地打磨;而 Cranelift 的設計哲學完全不同,它大幅刪減了這些最佳化步驟,只進行最基本的暫存器配置與指令選擇,透過一次線性掃描便完成程式碼產生,不再反覆迭代。同時,它的中介表示設計也更加輕量,專門用於將上層中介表示快速轉譯為機器碼,不像 LLVM IR 那樣背負著數十年通用化設計留下的包袱。
好處說完了,代價呢?最明顯的一條是 Cranelift 產生的程式碼跑起來比 LLVM 慢,依場景不同大約慢 10%~30%。但想開了就會發現,這在開發階段根本不重要。我要那麼快做什麼?我是在跑分,還是在做 CI 的 release 建置?我 就是要 cargo build 快一點,好看看邏輯有沒有跑出來。而且我敢打賭,你寫的大部分程式不可能有 80% 以上的時間把運算資源佔滿,總得有實際的工作進來才行,而開發的時候能有多少工作?CPU 怕是全程都在 ,反倒是我這邊要看效果、要驗證邏輯。那麼拿編譯時間換執行效率,這筆帳放進開發循環裡,是不是應該倒過來算?
程式碼生成單元
再來談談 codegen-units。這個參數控制編譯器將 crate 拆分成多少個最小單元,交由後端平行處理。預設情況下,偵錯模式為 256 個,釋出模式為 16 個。數字越大,平行程度越高,編譯也越快,因為後端程式碼產生可以同時運用多個 CPU 核心。但代價是最佳化效果會變差:每個單元都是獨立最佳化的,LLVM(或 Cranelift)能看到的上下文更少,跨單元內嵌和最佳化的機會也隨之減少。
但在真正的發行建置中,通常應該使用另一個極端的參數 codegen-units = 1,只有這樣才能讓產出得到最大程度的最佳化。畢竟都用 Rust 了,用編譯時間換取執行時效能難道不是理所當然的嗎?
最佳化等級
另一個經常被忽略但可以調整的設定是 opt-level,預設值應該是 "3",但發行版本更常見的做法是設為 "z";這不必修改程式碼就能免費縮小產出物的體積,何樂而不為呢?不過在開發模式下,這裡應該設定為 "0",完全不最佳化才能獲得最快的建置速度。
另外還有一個小技巧:Cargo.toml 其實可以為相依套件和自己的程式碼設定不同的最佳化等級:
[profile.dev.package."*"]
opt-level = 3
這樣就可以使用 O3 編譯第三方相依套件,只會增加首次全新編譯所需的時間,後續都是增量編譯。外部相依套件通常不會頻繁更新,因此對它們使用 O3、對自己的應用程式碼使用 O0,一般可以在速度與體積之間取得良好平衡,帶來不錯的開發模式體驗。不過在發布模式下,我仍然建議直接將最佳化拉滿到 O3 或 Z,沒什麼好說的。
連結時最佳化
LTO(連結時最佳化)是另一項非常消耗記憶體和編譯時間的功能,但大多數專案都建議在發行建置中啟用它。正常編譯時,每個 crate 都會獨立最佳化,編譯器後端無法看到 crate 之間的呼叫關係,因此無法執行某些跨 crate 內嵌和無用程式碼消除,而這種情況非常常見。LTO 會打破這個邊界,讓最佳化器在連結時取得所有 crate 的中間表示,並進行一次全域最佳化。不過,千萬不要不加考慮地直接在設定檔中加入 lto = true,否則 Rust 編譯會慢得讓你懷疑人生;請仔細檢查,只在使用發行設定檔時啟用它。
移除偵錯符號
和其他東西一樣,Rust 的偵錯資訊和符號就存放在這裡。在發布模式下啟用 strip 可以大幅縮減體積(通常是 50 MB 對 5 MB),差距大得離譜。移除符號也更加安全,畢竟大多數時候,前端原始碼外洩都是因為不小心把原始碼對應表發布到了 npm 上 :(
所以開發設定檔下沒什麼好說的,你總不能剝除偵錯資訊吧,否則就無法用 gdb / lldb 正常偵錯,堆疊回溯裡也看不到有意義的函式名稱。不過要注意,Arch Linux 打包時預設會幫你剝除,但這和我們有一點小衝突:我們已經剝除過了,後面可能會報錯。撰寫 AUR 軟體包時可以留意一下,明確略過這一步。
放棄 panic!
在正常的業務中,panic 不應該存在。正常業務程式碼在執行階段遇到錯誤時,只要是設計了容錯機制的 Err,都應該被安全傳回,而不是粗暴地觸發恐慌;就像 React ErrorBoundary 一樣,它應該被正常地當作錯誤處理。只有當程式碼確信自己進入了不可能且無法挽回的狀態時,才應該觸發恐慌。我的個人哲學是放棄恐慌。為什麼?因為實際上可以把業務程式碼測試分成三層:第一層是正確路徑,第二層是錯誤路徑(無限種可能中的一種),第三層才是透過模糊測試或碰撞測試窮舉出來的邊界情況。從工程角度來說,正確路徑可以做到 100% 覆蓋;錯誤路徑可以從一類的 n 種變體中選取一種;碰撞測試則純粹是時間問題,大多數時候並不值得。等你的使用者規模真的上來了,需要做的時候你自然會知道;通常我一律不做。
那麼,好的程式碼就應該用測試涵蓋一類成功路徑和至少一種錯誤路徑。這一類錯誤路徑只要涵蓋一個案例,就足以測試錯誤是否會以 Err 回傳,進而編寫備援邏輯,並自然地透過 thiserror 列舉,或用 anyhow 攔截、扁平化、列印和記錄。總之,你的程式碼會迫使你建立處理這些情況的機制。做到這一層後,panic 對你就沒有用了,可以將其理解為「理論上不可能」,但也僅僅是理論上。現實世界中還有作業系統錯誤、記憶體錯誤、宇宙射線單電子造成的位元翻轉、各種奇怪的溢位……你永遠不可能涵蓋所有這類情況。那麼,為什麼不要觸發恐慌呢?因為這些情況很可能——有 90% 的機率——並不是你的程式碼造成的。panic 的本質在於,發生時 Rust 會沿著呼叫堆疊逐層返回,依次呼叫每個堆疊框架中的解構函式(drop)來清理資源。這個過程需要編譯器產生額外的 unwind 表格,用來找出商業邏輯中的錯誤。如果錯誤本身很可能並非源自你的程式碼,這些資訊又有什麼價值?保留它還會增加編譯產物的大小,並加重連結器的工作量,因此關掉才是正確選擇。如果程式碼測試充分,而且你有足夠的信心,建議設定 panic = abort。
實際測試
多說無益,實際看看這些組合帶來的提升吧。這裡以我幾個月前做的一個小玩具專案為參考。
這個專案的 Rust 部分大約有 3.2 萬行原始碼,不含相依套件。
Rendering is a protocol, not a render-time computation.
這個儲存庫其實是一個包含許多子專案的單一儲存庫,但其中可以找出兩個典型的例子。先看看 Skeleton 這個套件,它的特點非常明顯:程式碼量大,依賴極少。這個套件的程式碼生成占比將是整個專案中最高的,因此特別適合 Cranelift 發揮。此外,這個套件也很乾淨——這裡的「乾淨」是指完全以安全 Rust 編寫。
反觀下面這個命令列介面套件就不太合適了。相依套件多倒不是什麼問題,理論上反而更能體現效率,但這裡有一個經典的二選一:左上角可以看到 ring 這個相依套件被標記為選用。這是因為專案原本使用的是 aws-lc-rs,兩者都是 Rust 中的加密演算法後端。可為什麼要設為選用呢?因為 ring 完全以 Rust 撰寫,另一個則是透過外部函式介面引入的組合語言實作,專門針對 x86、arm64 等主流中央處理器架構進行組合語言層級的加速。然而問題也恰恰出在這裡:Cranelift 的魔法只適用於純 Rust;一旦引入不安全程式碼、透過外部函式介面呼叫的 C 或組合語言等內容,Cranelift 的相容性實際上就會變得極差。
不過這個問題並非無解:可以使用 cfg 選擇後端,並在 Cranelift 模式下使用 ring 編譯。按照上述說明設定好開發與發行設定檔後,只要簡單比較一下命令列工具的編譯速度,就會發現開發建置至少比發行建置快三倍,而且這還是在沒有增量編譯的冷編譯情況下。使用 O0 並關閉連結時最佳化後,開發設定檔在後續增量更新中的速度應該能比發行設定檔快數十倍。連結時最佳化之類的技術實際上仰賴消除各個 crate 之間的邊界來實現最佳化;當它們合併成一個整體後,只要修改一處程式碼,整個整體都必須重新編譯,因此無法正確進行增量更新。


綜合結果來看,這兩者其實差不多,稱不上質變,但差異絕對能明顯感受到。主要原因是 Apple Silicon 太強了:M 系列晶片的單核心效能和記憶體頻寬都高得離譜,而編譯這種既重運算又重 I/O 的工作正好能吃到這些優勢。通常換成 Linux 跑,差距會更大;但如果是在 MacBook 上安裝 Asahi Linux 之類的系統,那肯定是 Linux 勝出。
老舊的連結器
在 Linux 上,Rust 預設使用 GNU ld(bfd)——對,就是那個最老、最慢的連結器。它採用單執行緒,符號解析和重定位也都透過循序掃描完成,專案一大就會明顯拖慢速度。在 Linux 上可以試試 @Rui Ueyama 編寫的 mold,設定很簡單,只要在 .cargo/config.toml 中加入一行即可。
[target.x86_64-unknown-linux-gnu]
linker = "clang"
rustflags = ["-C", "link-arg=-fuse-ld=mold"]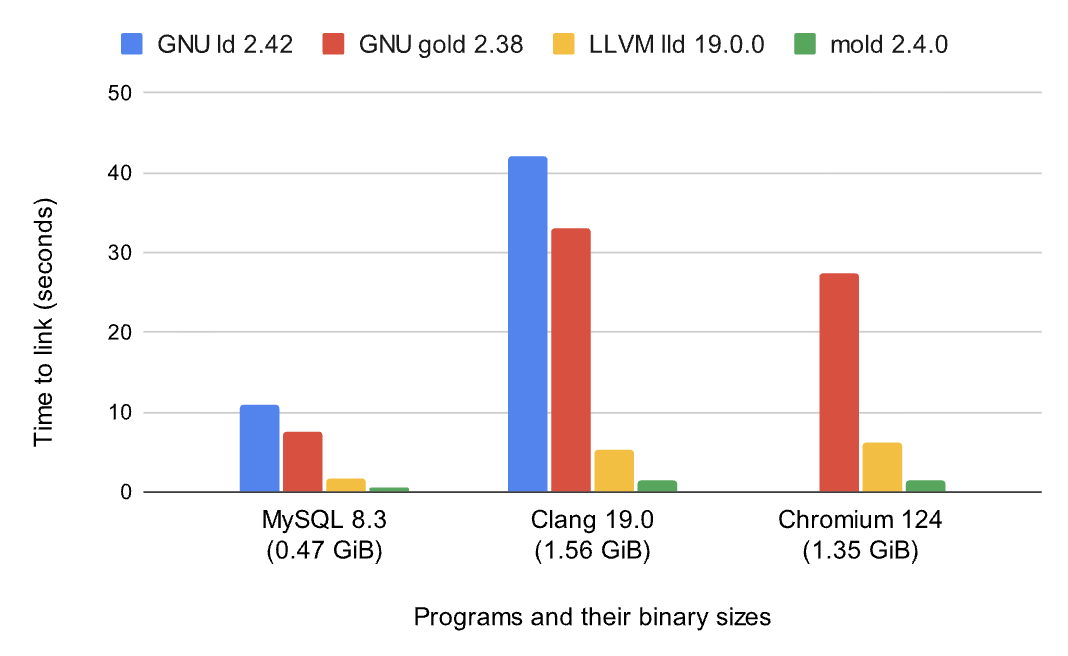
提升還是很明顯的,但遺憾的是,macOS 上只有 sold 這個商業專案。好消息是,macOS 上的 lld 和 Apple 內建的 ld64 本來就不慢,尤其是 Xcode 15 之後推出的新連結器,速度提升極其明顯。不過它唯一的缺點是,macOS 無人值守 CI 在每次更新後都必須用 sudo 接受一份協議,導致我的 CI 排程工作好幾次都掛掉了。
MUSL 與 glibc
我本人是個 ,非常討厭 GNU glibc,但開發階段我還是推薦你用 x86_64-unknown-linux-gnu。為什麼呢?因為快。MUSL 最大的賣點是能產生完全靜態連結的二進位檔——不依賴系統上的任何動態函式庫,編譯出來的東西拷到任何一台 Linux 機器上都能直接跑,特別適合容器與嵌入式場景。但慢也慢在靜態連結上:連結器需要把所有東西都打包進去,連結階段的工作量比動態連結大得多。
不過好消息是,如果你使用 macOS,就完全不用擔心這些了:aarch64-apple-darwin 是目前唯一的選擇。macOS 在設計上就不支援完全靜態連結,從編譯速度的角度來看,這反而是件好事。因此,開發設定檔在 Linux 上使用 GNU libc,在 macOS 上使用 libSystem;發布設定檔在 macOS 和 Linux 上都可以使用 musl。由於 macOS 預設選擇的連結器和封存工具有所不同,唯一需要注意的是可能得設定一下 .cargo/config.toml。
[target.x86_64-unknown-linux-musl]
linker = "x86_64-linux-musl-gcc"
ar = "x86_64-linux-musl-ar"
順帶提醒一下,千萬不要用 Zig:zbuild 目前在 Rust Nightly 上問題很大。需要交叉編譯時,如果主機是 Linux x86,推薦使用搭配 Docker 編譯的 cross,效果很好,環境也一應俱全。如果你偏好 glibc,這也是個很好用的選擇。由於 glibc 只保證向後相容,通常的經驗做法是使用比目前版本早兩個主要版本的 Debian 所附帶的 glibc 版本來編譯;否則,過新的 glibc 會讓程式無法在大量機器上執行。這並不是因為用了什麼新功能,它就只是檢查字串裡的版本號來氣你。如果主機是 Mac,請使用 rustup 原生的 target + cargo build --release
UPX 是個壞東西
還有一點值得討論,那就是 UPX 的使用;我知道我說過自己喜歡 musl,但同時又追求小體積其實很矛盾,聽起來也不太合理……
                 ooooo     ooo  ooooooooo.  ooooooo  ooooo
                 `888'     `8'  `888   `Y88. `8888    d8'
                  888       8    888   .d88'   Y888..8P
                  888       8    888ooo88P'     `8888'
                  888       8    888           .8PY888.
                  `88.    .8'    888          d8'  `888b
                    `YbodP'     o888o       o888o  o88888o


                    The Ultimate Packer for eXecutables
   Copyright (c) 1996-2026 Markus Oberhumer, Laszlo Molnar & John Reiser
                           https://upx.github.io
但實際上,UPX 的存在解決了這個問題。UPX 的原理是壓縮二進位檔,再為其包上一個解壓縮存根;執行時先在記憶體中解壓縮,然後再執行。這樣可以將二進位檔壓縮至原始大小的 30%~50% 左右,體積上的優勢會非常明顯。但也正因如此,UPX 與 GNU glibc 動態連結搭配時會出現嚴重問題:使用 glibc 動態連結的二進位檔包含一些特殊的區段和動態載入機制,UPX 壓縮後可能會破壞這些結構,導致執行時找不到動態函式庫 segment fault。反觀 musl,它就非常適合 UPX:原本就是完全靜態連結,內部結構穩定,經 UPX 壓縮後,解壓縮和執行都很乾淨。因此,在 musl 的發佈 CI 中增加一道 UPX 步驟,其實是非常加分的。
另外,UPX 也不能濫用,它只適合長時間或低頻率的工作。之所以適合長時間工作,是因為 UPX 啟動時需要在記憶體中解壓縮一次;這個過程雖然完全自動化,也只會增加一點冷啟動時間,但放在高頻路徑上仍然可能造成致命影響。因此,那些只啟動一次、之後長期在背景執行的工作很適合使用 UPX。不過,我並不建議不加思索地替 docker 映像中這類長時間執行的服務套件加上 UPX,因為這實際上是在用記憶體換取磁碟空間,完全得不償失;而容器 Layer 的壓縮其實已經能發揮與 UPX 相同的作用,減少散布時的下載大小。相比之下,我更推薦將它用於某些 CLI:不僅能節省大量磁碟空間,啟動時的解壓縮時間也幾乎無感,而且 musl 天生就很適合建構 CLI。不然我就要點名批評 AUR 助手了:那個用 go 寫的東西居然沒有靜態連結,導致我曾經遇過 ArchLinux 上的 yay 因找不到動態函式庫而故障;偏偏它本身又是系統管理工具,根本無從修復,只能另外啟動 LiveISO,最後透過 chroot 把系統救回來。
總結
最後,這些好用的設定雖然可以幫助你快速區分開發與發佈設定檔,而且隨著專案程式碼增加,效果只會愈來愈明顯,但我還是建議你再寫一個持續整合工作來執行 Rust 穩定版 LLVM 建置,最好連同各種測試一起執行。這樣本機也不用切換 Rust 每夜版,邊界情況也坑不到你,推送上去的問題會被持續整合攔下,這就是目前最舒服的開發者體驗模式;這次就說到這裡,下次有空再折騰吧。