나는 오래전부터 Rust를 좋아해 왔습니다. 장점은 분명하지만 단점도 그만큼 분명합니다. 쓰레기 수집 없이 보장되는 메모리 안전성, 비용 없는 추상화, 동시성 안전성, 현시점에서 거의 최고라 할 만한 도구 체계와 주변 생태계, 클라우드 웹 서버부터 마이크로컨트롤러까지 아우르는 막강한 적용 범위, 그리고 매우 뛰어난 오류 처리 설계를 갖추고 있습니다. 단점이라면? 가파른 학습 곡선? 소유권과 빌림 같은 모델의 제약을 이해하기 어렵다는 점? 코드를 작성하는 데 오래 걸린다는 점?
오랫동안 우리는 이것들이 Rust의 단점이라고 생각해 왔습니다. 하지만 실제로 앞의 두 가지는 사고방식과 인식을 훈련하면 해결할 수 있는 반면, 느린 컴파일 속도는 계속해서 제 작업 흐름을 늦춰 왔습니다. 몇 년 전까지만 해도 이 모든 것이 괜찮아 보였습니다. AI가 몰아치기 전의 제게는 무엇보다 인내심이 있었고, 알고리즘 하나나 기능 하나를 새벽까지 작성하곤 했습니다. 하지만 지금은 어떨까요? 제가 변하지 않았다고는 도저히 말하기 어렵습니다. 저는 조금의 인내심도 없어졌고, Rust 코드를 어떻게 작성할지 조금도 고민하고 싶지 않으며, Cargo의 길고 긴 진행 표시줄을 도저히 기다릴 수 없게 되었습니다. 특히 ld 단계에서는 진행 상황조차 표시되지 않은 채 매번 그대로 멈춰 있기만 하니, 정말 견디기 어렵습니다.
이 모든 문제를 해결할 방법은 정말 없는 걸까요? 사실 방법은 있습니다. 약 한 달 전부터 작업 흐름 최적화를 비롯해 Rust 개발 과정을 더 빠르게 만들 여러 방법을 시도해 봤지만, 실제 대기 시간은 거의 매번 Cargo에서 발생했습니다. 이 문제를 해결하지 못하면 다른 개선책은 근본적인 해결이 될 수 없습니다. 그래서 이번 기회에 Rust 개발에서 Cargo.toml 설정을 조정하는 방법과 이를 뒷받침하는 주변 설정에 관해 간단히 이야기해 보려 합니다.
백엔드 이론
Rust 설계에서는 LLVM이 다소 게으른 면이 있지만 선택 자체는 매우 훌륭합니다. Go처럼 기계어로 변환하는 과정을 스스로 관리하는 것이 아니라, 큰 LLVM 생태계가 성숙한 최적화를 담당하게 하는 것은 실제로 좋은 접근입니다. 전체 Rust 컴파일 흐름은 대략 다음과 같이 설명할 수 있습니다. 소스 코드는 먼저 어휘 분석과 구문 분석을 거쳐 추상 구문 트리(AST)를 생성하고, 이어서 매크로 전개와 HIR 하향 평탄화를 수행합니다. 그 후 일반적인 타입 검사와 약간의 빌림 검사(borrow checking)를 거쳐 최종적으로 MIR을 생성합니다. 여기까지는 모두 Rust 컴파일러 자체 프런트엔드가 처리합니다.
MIR 이후의 작업은 LLVM에 맡깁니다. 예를 들어 MIR을 LLVM IR로 변환하고, LLVM이 O0부터 O3까지의 최적화 패스를 수행합니다. 마지막으로 대상 플랫폼용 머신 코드를 생성한 뒤 링크러에게 전달하여 BIN 실행 파일로 결합합니다.
그렇다면 문제는 대체 어디에 있을까요? 답은 사실 아주 간단합니다. LLVM은 매우 무거운 기반 시설이며, 프로덕션 환경에서는 무거운 것이 옳습니다. 컴파일 시간을 들여 실행 시간을 줄이는 것은 훌륭한 철학입니다. LLVM은 상위 계층의 Rust뿐 아니라 C, C++, Swift 등 수많은 언어를 연결합니다. 이는 LLVM의 최적화 파이프라인이 “최적의 기계어를 생성하는 것”을 목표로 설계되었지, “컴파일을 빠르게 끝내는 것”을 목표로 설계된 것이 아니라는 뜻입니다. release 모드에서 수십 개의 최적화 단계를 한 차례 실행하는 데에는 매우 많은 시간이 듭니다. debug 모드의 O0에서도 LLVM은 여전히 중간 표현 생성부터 기계어 생성까지의 전체 과정을 거쳐야 하며, 이 과정 자체도 결코 가볍지 않습니다. 게다가 Rust의 제네릭 단형화는 컴파일 시점에 대량의 코드를 펼치므로 LLVM에 전달되는 중간 표현의 규모가 소스 코드에서 보이는 것보다 훨씬 커지고, 그에 따라 LLVM이 처리해야 하는 작업량도 자연스럽게 불어납니다.
Cranelift
그러니까 본질적으로, 컴파일이 느린 시간의 상당 부분은 Rust 자체의 프런트엔드가 아니라 LLVM이라는 "중량급 백엔드"에서 소모됩니다. 그럼 여기서 문제, 이걸 버릴 수는 없을까요? Cranelift라는 백엔드가 바로 이 요구를 위해 만들어졌습니다. 처음 이름은 Cretonne였고 2016년에 시작되어 Bytecode Alliance가 개발했으며, 애초에 Wasmtime을 위해 코드 생성 백엔드였습니다. 이후 Rust 공식 프로젝트에 편입되어 선택 가능한 codegen 백엔드가 되었습니다.


그렇다면 Cranelift는 정확히 어느 지점에서 빨라야 할까요? 가장 빛을 발하는 때는 개발 단계입니다. 이때는 실행 효율을 극한까지 최적화한 거의 완벽한 기계어 코드가 전혀 필요하지 않을 수도 있고, 그저 빠른 피드백만 있으면 될 수도 있습니다. 다소 품질이 떨어지는 이 기계어 코드가 LLVM이 제대로 생성한 기계어 코드와 의미상 동등하기만 하면 됩니다. 초기 Cranelift는 수많은 경계 사례 때문에 실제로 이를 보장하지 못했습니다. 지금도 그런 사례가 남아 있기는 하지만 크게 개선되어, 이제 Cranelift에서는 실행되는데 LLVM에서는 실패하는 상황이 발생할 확률은 Rust 코드를 작성하다 rustc의 내부 컴파일러 오류를 유발할 확률과 비슷한 수준입니다. LLVM은 극도로 최적화된 기계어 코드를 생성하기 위해 반복문 펼치기, 벡터화, 상수 전파, 죽은 코드 제거 등을 비롯한 수십 개의 최적화 단계를 실행하며 코드를 여러 겹에 걸쳐 다듬습니다. 반면 Cranelift의 설계 철학은 완전히 다릅니다. 이런 최적화 단계를 대폭 줄이고 가장 기본적인 레지스터 할당과 명령어 선택만 수행하며, 반복해서 순회하지 않고 한 번의 선형 스캔으로 코드 생성을 끝냅니다. 중간 표현의 설계도 더 가벼워서 상위 중간 표현을 기계어 코드로 빠르게 변환하는 데 특화되어 있으며, 수십 년간 쌓인 범용화의 짐을 짊어진 LLVM IR과는 다릅니다.
장점은 다 말했으니, 대가는? 우선 뻔한 것부터 보겠습니다. Cranelift가 만들어낸 코드는 LLVM의 것보다 실행이 느립니다, 상황에 따라 대략 10%~30% 정도. 하지만 마음을 놓고 보면 알게 됩니다, 개발 단계에서 이건 전혀 중요하지 않다는 걸. 그 속도가 나한테 왜 필요할까요? 벤치마크를 돌리나, CI의 release 빌드를 하나? 나는 cargo build가 좀 빨리 끝나서 로직이 나왔는지 보고 싶을 뿐입니다. 게다가 장담하는데, 여러분이 쓰는 프로그램 대부분은 계산 자원을 80% 넘는 시간 동안 꽉 채울 리가 없습니다. 실제 작업이 들어와야 하는데, 개발할 때 그 작업이 얼마나 되겠습니까? CPU는 아마 처음부터 끝까지 있을 거고, 정작 결과를 보고 로직을 확인해야 하는 건 나입니다. 그렇다면 컴파일 시간을 실행 효율과 맞바꾸는 이 계산, 개발 루프 안에서는 거꾸로 따져야 하는 것 아닐까요?
코드 생성 단위
이어서 codegen-units에 관해 이야기해 보겠습니다. 이는 컴파일러가 crate를 몇 개의 최소 단위로 나누어 백엔드에서 병렬로 처리할지를 제어하는 매개변수입니다. 기본값은 디버그 모드에서 256개, 릴리스 모드에서 16개입니다. 숫자가 클수록 병렬성이 높아지고 컴파일도 빨라집니다. 여러 CPU 코어를 동시에 활용해 백엔드 코드 생성을 실행할 수 있기 때문입니다. 하지만 각 단위가 독립적으로 최적화되므로 LLVM(또는 Cranelift)이 볼 수 있는 문맥이 줄어들고, 단위를 넘나드는 인라인화와 최적화 기회도 감소해 최적화 효과가 떨어집니다.
하지만 실제 릴리스 빌드에서는 일반적으로 반대쪽 극단값인 codegen-units = 1을 사용해야 합니다. 그래야만 결과물을 최대한으로 최적화할 수 있습니다. 어차피 Rust를 쓰고 있다면 컴파일 시간을 런타임 성능과 맞바꾸는 것이 당연하지 않을까요?
최적화 수준
자주 간과되지만 조정할 수 있는 또 다른 설정은 opt-level입니다. 기본값은 "3"이지만, 릴리스 빌드에서는 일반적으로 "z"로 설정합니다. 코드를 수정하지 않고도 결과물의 크기를 줄일 수 있는 공짜 최적화인데 사용하지 않을 이유가 있을까요? 다만 개발 모드에서는 최적화를 완전히 비활성화해야 가장 빠른 빌드 속도를 얻을 수 있으므로 "0"으로 설정해야 합니다.
또 다른 유용한 요령은 Cargo.toml에서 의존성과 자체 코드에 서로 다른 최적화 수준을 설정할 수 있다는 것입니다:
[profile.dev.package."*"]
opt-level = 3
이렇게 하면 서드 파티 의존성을 O3로 컴파일할 수 있으며, 최초의 클린 빌드 시간만 늘어나고 이후에는 증분 빌드가 이루어집니다. 외부 의존성은 일반적으로 자주 업데이트되지 않으므로, 의존성에는 O3를 사용하고 자체 애플리케이션 코드에는 O0를 사용하면 대부분 속도와 바이너리 크기 사이에서 균형 잡힌 쾌적한 개발 모드 경험을 얻을 수 있습니다. 하지만 릴리스 모드에서는 여전히 O3나 Z로 최적화를 최대로 높이는 것을 권장합니다. 이 부분은 달리 말할 것도 없습니다.
링크 타임 최적화
LTO(링크 타임 최적화)는 메모리와 컴파일 시간을 매우 많이 소모하는 또 하나의 기능이지만, 대부분의 프로젝트에서는 릴리스 빌드에 활성화하는 것이 권장됩니다. 일반 컴파일에서는 각 크레이트가 독립적으로 최적화되므로 컴파일러 백엔드가 크레이트 사이의 호출 관계를 볼 수 없고, 그 결과 일부 크레이트 간 인라인화와 불필요한 코드 제거를 수행할 수 없습니다. 이런 경우는 매우 흔합니다. LTO는 이 경계를 허물어 링크할 때 모든 크레이트의 중간 표현을 최적화기에 제공하고 한 차례 전역 최적화를 수행하게 합니다. 하지만 프로필에 무턱대고 lto = true을 직접 추가하면 Rust 컴파일이 견디기 힘들 정도로 느려지므로, 설정을 꼼꼼히 확인하고 릴리스 프로필을 사용할 때만 활성화하세요.
디버그 심볼 제거
다른 것들과 마찬가지로 Rust의 디버그 정보와 심벌도 여기에 저장됩니다. 릴리스 모드에서 strip을 활성화하면 크기를 상당히 줄일 수 있습니다(보통 50MB 대 5MB). 정말 터무니없는 차이입니다. 심벌을 제거하면 더 안전하기도 합니다. 프런트엔드 소스 코드가 유출되는 경우는 대부분 소스 맵을 실수로 npm에 게시했기 때문입니다 :(
그러므로 개발 프로필에 관해서는 딱히 할 말이 없습니다. 디버그 정보를 제거할 수는 없으니까요. 그렇게 하면 gdb / lldb로 정상적으로 디버깅할 수 없고 스택 역추적에서도 의미 있는 함수 이름을 볼 수 없습니다. 다만 Arch Linux는 패키징할 때 기본적으로 이를 제거해 준다는 점에 유의해야 합니다. 여기서 약간의 충돌이 생기는데, 이미 제거한 상태라 나중에 오류가 발생할 수 있습니다. AUR 패키지를 작성할 때는 이 단계를 명시적으로 건너뛰세요.
패닉을 버리자!
일반적인 비즈니스 코드에는 panic 이 존재해서는 안 됩니다. 정상적인 비즈니스 코드가 실행 중 오류를 만났을 때, 내결함성을 고려해 설계된 Err라면 모두 안전하게 반환되어야 하며 거칠게 패닉을 일으켜서는 안 됩니다. React ErrorBoundary처럼 정상적인 오류로 처리해야 합니다. 패닉은 코드가 불가능한 상태에 진입했으며 복구할 수도 없다고 확신할 때만 일으켜야 합니다. 제 개인적인 철학은 패닉을 포기하는 것입니다. 왜일까요? 실제로 비즈니스 코드의 테스트는 세 계층으로 나눌 수 있기 때문입니다. 첫 번째는 성공 경로, 두 번째는 오류 경로(무한히 많은 가능성 중 하나), 세 번째가 비로소 퍼징이나 충돌 테스트로 샅샅이 찾아낸 경계 사례입니다. 공학적으로 성공 경로는 100% 테스트할 수 있고, 오류 경로는 한 범주의 n가지 변형 중 하나를 선택할 수 있습니다. 충돌 테스트는 순전히 시간의 문제이며 대부분은 그만한 가치가 없습니다. 사용자 규모가 정말 커지면 언제 해야 하는지 스스로 알게 되므로, 저는 보통 아예 하지 않습니다.
따라서 좋은 코드라면 한 종류의 정상 경로를 다루는 테스트와 적어도 하나의 오류 경로를 다루는 테스트가 있어야 합니다. 같은 종류의 오류 경로는 한 사례만 다뤄도 오류가 Err로 반환되는지 시험할 수 있으므로, 대체 논리를 작성하고 자연스럽게 thiserror로 열거하거나 anyhow로 가로채 평탄화하고 출력하고 기록할 수 있습니다. 요컨대 코드 자체가 이런 상황을 처리할 장치를 작성하도록 강제합니다. 이 단계까지 해냈다면 panic는 쓸모가 없으며, 이를 “이론상 불가능”이라고 이해할 수 있습니다. 하지만 어디까지나 이론상일 뿐입니다. 현실에는 운영체제 오류, 메모리 오류, 우주선의 단일 전자로 인한 비트 반전, 기묘한 오버플로 등이 있으며, 이런 상황을 전부 다루는 것은 영원히 불가능합니다. 그렇다면 왜 패닉을 일으키지 않아야 할까요? 이런 상황은 높은 확률로, 즉 90%의 확률로 코드 문제가 아니기 때문입니다. panic의 본질은 그것이 발생할 때 Rust가 호출 스택을 한 단계씩 거슬러 올라가면서 각 프레임의 소멸자(drop)를 차례로 호출해 자원을 정리한다는 데 있습니다. 이 과정에는 비즈니스 논리의 오류 지점을 찾기 위해 컴파일러가 생성하는 추가 unwind 테이블이 필요합니다. 오류 자체가 코드에서 비롯되지 않았을 가능성이 높다면 그 정보가 무슨 가치가 있겠는가? 이를 남겨 두면 컴파일 산출물의 크기도 커지고 링커의 작업량도 늘어나므로, 끄는 것이 정답입니다. 코드를 충분히 테스트했고 그만큼 자신이 있다면 panic = abort 설정을 권합니다.
실제 테스트
말로만 설명해 봐야 소용없으니, 몇 달 전에 만든 작은 토이 프로젝트를 예로 들어 이러한 조합이 실제로 얼마나 개선되는지 살펴보겠습니다.
이 프로젝트의 Rust 부분은 의존성을 제외하면 소스 코드가 약 3만 2천 줄입니다.
Rendering is a protocol, not a render-time computation.
이 저장소는 실제로 많은 하위 프로젝트를 포함한 모노레포지만, 그중에서 두 가지 대표적인 사례를 찾을 수 있습니다. 먼저 Skeleton 패키지를 살펴보면 특징이 매우 분명합니다. 코드 양은 많고 의존성은 극히 적습니다. 이 패키지는 전체 프로젝트에서 코드 생성이 차지하는 비중이 가장 높을 것이므로 Cranelift의 강점을 발휘하기에 특히 적합합니다. 또한 이 패키지는 매우 깔끔한데, 여기서 “깔끔하다”는 것은 전부 안전한 Rust로 작성되었다는 뜻입니다.
반면 아래의 명령줄 인터페이스 패키지는 그다지 적합하지 않습니다. 의존성이 많은 것 자체는 별문제가 아니며, 이론상으로는 오히려 효율을 더 잘 보여 줄 수 있지만, 여기에는 전형적인 양자택일 문제가 있습니다. 왼쪽 위를 보면 ring 의존성이 선택 사항으로 표시되어 있습니다. 이는 이 프로젝트가 원래 aws-lc-rs 을 사용했기 때문이며, 둘 다 Rust의 암호화 알고리즘용 백엔드입니다. 그런데 왜 선택 사항으로 두었을까요? ring 은 순수 Rust로 작성된 반면, 다른 하나는 외부 함수 인터페이스를 통해 가져온 어셈블리 구현으로, x86과 arm64 같은 주류 중앙 처리 장치 아키텍처에 맞춰 어셈블리 수준에서 가속되기 때문입니다. 하지만 바로 이 점이 약점이기도 합니다. Cranelift의 마법은 순수 Rust에만 통하며, 안전하지 않은 코드나 외부 함수 인터페이스를 통한 C 또는 어셈블리 등을 도입하는 순간 Cranelift의 호환성은 사실상 매우 나빠집니다.
하지만 이 문제에도 해결책은 있습니다. cfg로 백엔드를 선택하고 Cranelift 모드에서는 ring을 사용해 컴파일하면 됩니다. 위에서 설명한 대로 개발용 및 릴리스용 프로필을 설정한 뒤 CLI의 컴파일 속도를 간단히 비교해 보면, 이 조건에서는 개발 빌드가 릴리스 빌드보다 최소 3배 빠릅니다. 더구나 이는 증분 컴파일을 사용하지 않은 콜드 빌드 기준입니다. 최적화 수준을 O0으로 설정하고 링크 시간 최적화를 끄면 이후의 증분 업데이트에서는 개발용 프로필이 릴리스용 프로필보다 수십 배 이상 빨라야 합니다. 링크 시간 최적화 같은 기법은 실제로 각 패키지의 경계를 평탄화하여 작동하므로, 모든 것이 하나로 합쳐진 뒤에는 코드 한 곳만 수정해도 전체를 다시 컴파일해야 하며 올바른 증분 업데이트를 수행할 수 없습니다.


종합적인 결과를 보면 둘은 사실 큰 차이가 없습니다. 질적인 도약이라고 할 정도는 아니지만, 차이는 분명하게 체감됩니다. 주된 이유는 Apple Silicon이 워낙 강력하기 때문입니다. M 시리즈 칩은 싱글 코어 성능과 메모리 대역폭이 터무니없이 뛰어나며, 연산과 I/O 부하가 모두 큰 컴파일 작업은 이런 장점을 그대로 활용합니다. 일반적으로 Linux에서 실행하면 격차가 더 벌어지지만, MacBook에 Asahi Linux 같은 것을 설치해 비교한다면 단연 Linux가 이깁니다.
구식 링커
Linux에서 Rust는 기본적으로 GNU ld(bfd)를 사용합니다. 맞습니다. 가장 오래되고 가장 느린 바로 그 링커입니다. 단일 스레드로 동작하는 데다 심벌 해석과 재배치도 모두 순차 탐색으로 처리하므로 프로젝트가 커지면 눈에 띄게 발목을 잡습니다. Linux에서는 @Rui Ueyama가 만든 mold를 사용해 볼 수 있으며, 설정도 .cargo/config.toml에 한 줄만 추가하면 될 정도로 간단합니다.
[target.x86_64-unknown-linux-gnu]
linker = "clang"
rustflags = ["-C", "link-arg=-fuse-ld=mold"]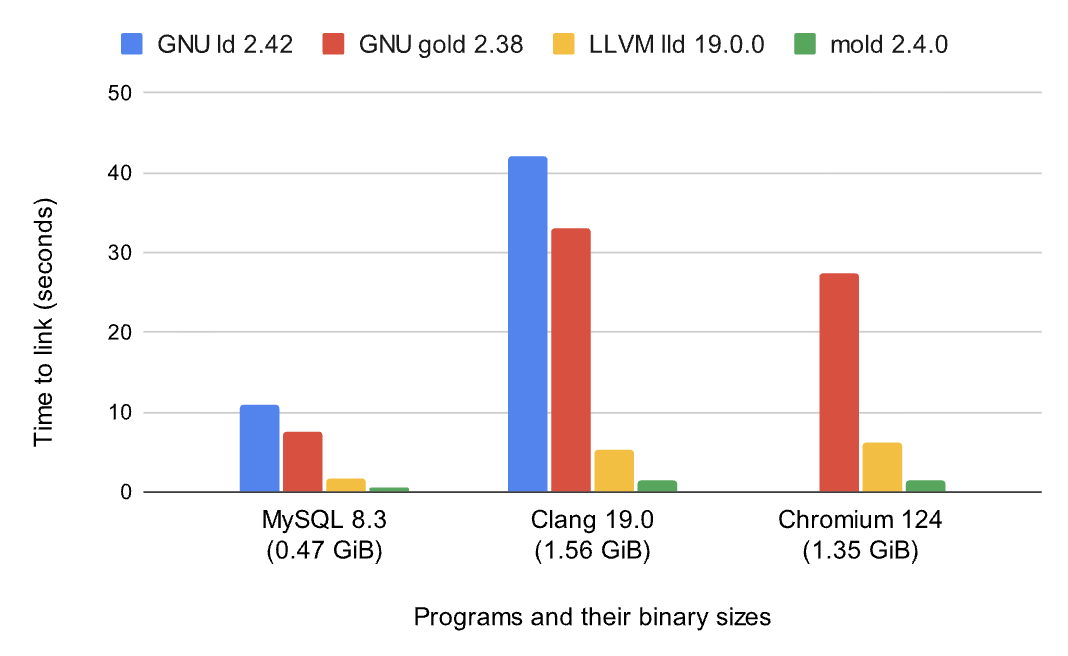
성능 향상은 상당히 뚜렷하지만, 안타깝게도 macOS에는 상용 프로젝트인 sold밖에 없습니다. 다행히 macOS의 lld와 Apple이 기본 제공하는 ld64도 원래 느리지 않으며, 특히 Xcode 15 이후 도입된 새 링커는 속도가 극적으로 향상되었습니다. 유일한 단점은 macOS 무인 CI에서 업데이트할 때마다 sudo로 약관에 동의해야 한다는 점인데, 이 때문에 예약된 CI 작업이 여러 번 실패했습니다.
MUSL과 glibc
저는 GNU glibc를 몹시 싫어하는 지만, 개발할 때는 그래도 x86_64-unknown-linux-gnu을 권합니다. 왜냐고요? 빠르니까요. MUSL의 가장 큰 장점은 완전히 정적 링크된 바이너리를 만들 수 있다는 점입니다. 시스템의 어떤 동적 라이브러리에도 의존하지 않으니, 빌드한 결과물을 아무 리눅스 머신에나 복사해도 그대로 실행되고, 컨테이너나 임베디드에 특히 잘 맞습니다. 하지만 느린 이유도 바로 그 정적 링크에 있습니다. 링커가 모든 것을 하나로 밀어 넣어야 하기 때문에 링크 단계의 작업량이 동적 링크보다 훨씬 큽니다.
그래도 좋은 소식은 macOS를 사용한다면 전혀 걱정할 필요가 없다는 것입니다. 현재로서는 aarch64-apple-darwin만이 유일한 선택지입니다. macOS는 설계상 완전 정적 링크를 지원하지 않는데, 컴파일 속도 측면에서는 오히려 좋은 일입니다. 따라서 개발 프로필은 Linux에서 GNU libc를, macOS에서 libSystem을 사용하고, 릴리스 프로필은 macOS와 Linux 모두에서 musl을 사용할 수 있습니다. macOS가 기본으로 선택하는 링커와 아카이버 때문에 유일하게 주의할 점은 .cargo/config.toml을 설정해야 할 수도 있다는 것입니다.
[target.x86_64-unknown-linux-musl]
linker = "x86_64-linux-musl-gcc"
ar = "x86_64-linux-musl-ar"
덧붙이자면 Zig는 절대 사용하지 마세요. 현재 Rust Nightly에서 zbuild는 문제가 아주 많습니다. 교차 컴파일이 필요하고 호스트가 Linux x86이라면 Docker와 함께 빌드하는 cross를 추천합니다. 필요한 환경이 모두 갖춰져 있어 매우 편리합니다. glibc를 선호하는 경우에도 좋은 선택입니다. glibc는 하위 호환성만 보장하므로, 일반적으로 Debian의 주요 배포판 버전보다 두 단계 이전에 포함된 glibc 버전을 기준으로 컴파일합니다. 그렇지 않으면 너무 새로운 glibc 때문에 수많은 컴퓨터에서 프로그램이 실행되지 않습니다. 새 기능을 사용해서가 아니라, 그저 문자열에 든 버전을 확인해 사람을 약 올리는 것입니다. 호스트가 Mac이라면 rustup 기본 target + cargo build --release 을 사용하세요
UPX는 나쁜 물건이다
또 하나 논의할 만한 점은 UPX의 사용입니다. 제가 musl을 좋아한다고 말해 놓고 동시에 작은 바이너리 크기까지 추구하는 것은 사실 꽤 모순적이고, 말이 안 되는 것처럼 들리죠...
                 ooooo     ooo  ooooooooo.  ooooooo  ooooo
                 `888'     `8'  `888   `Y88. `8888    d8'
                  888       8    888   .d88'   Y888..8P
                  888       8    888ooo88P'     `8888'
                  888       8    888           .8PY888.
                  `88.    .8'    888          d8'  `888b
                    `YbodP'     o888o       o888o  o88888o


                    The Ultimate Packer for eXecutables
   Copyright (c) 1996-2026 Markus Oberhumer, Laszlo Molnar & John Reiser
                           https://upx.github.io
하지만 실제로는 UPX가 이 문제를 해결해 줍니다. UPX는 바이너리를 압축한 뒤 압축 해제용 스텁으로 감싸며, 실행할 때 먼저 메모리에서 압축을 푼 다음 바이너리를 실행합니다. 이를 통해 바이너리 크기를 원본의 약 30~50%까지 줄일 수 있으므로 용량 면에서의 이점이 매우 커집니다. 그러나 바로 이런 원리 때문에 UPX와 GNU glibc 동적 연결을 함께 사용하면 큰 문제가 생길 수 있습니다. glibc로 동적 연결된 바이너리에는 특수한 섹션과 동적 적재 메커니즘이 있는데, UPX로 압축하는 과정에서 이런 구조가 손상되어 실행 시 동적 라이브러리를 찾지 못할 수 있습니다 segment fault. 반면 musl은 UPX와 매우 잘 맞습니다. 원래 완전 정적 연결 방식이고 내부 구조도 안정적이어서 UPX로 압축하고 해제하는 과정이 깔끔합니다. 따라서 musl 릴리스 CI에 UPX 단계를 하나 더 추가하면 상당한 이점이 있습니다.
또한 UPX를 남용해서는 안 되며, UPX는 장시간 실행되거나 실행 빈도가 낮은 작업에만 적합합니다. 장시간 실행 작업에 적합한 이유는 UPX가 시작할 때 메모리에서 한 번 압축을 풀어야 하기 때문입니다. 이 과정은 완전히 자동이고 콜드 스타트 시간도 조금만 늘어나지만, 자주 실행되는 경로에서는 여전히 치명적일 수 있습니다. 따라서 한 번 시작한 뒤 백그라운드에서 계속 실행되는 작업에는 잘 맞습니다. 다만 장시간 실행되는 서비스의 패키지라고 해서 docker 이미지에 무턱대고 UPX를 적용하는 것은 권하지 않습니다. 이는 사실상 메모리로 디스크 공간을 사는 행위라 손해가 막심하며, 컨테이너 Layer 압축도 배포 시 다운로드 용량을 줄인다는 점에서 이미 UPX와 같은 역할을 하기 때문입니다. 오히려 일부 CLI 용도에 사용하는 편을 권합니다. 디스크 공간을 아주 많이 절약하면서도 시작 시 압축 해제 시간은 거의 느껴지지 않고, musl도 본래 CLI에 잘 맞습니다. 그렇지 않다면 AUR 도우미를 대놓고 비판해야겠습니다. go로 만든 그 물건은 정적 링크조차 되어 있지 않아, 예전에 ArchLinux에서 yay가 동적 라이브러리를 찾지 못해 망가진 적이 있습니다. 정작 그 자체가 시스템 관리 도구라 해결할 방법도 없었고, 결국 별도의 LiveISO로 부팅한 뒤 chroot로 들어가 시스템을 복구해야 했습니다.
요약
마지막으로, 이런 유용한 설정을 사용하면 개발 프로필과 릴리스 프로필을 빠르게 구분할 수 있고 프로젝트 코드가 늘어날수록 그 효과도 더욱 뚜렷해지지만, 그래도 Rust 안정 버전 LLVM 빌드를 실행하는 지속적 통합 작업을 하나 더 만들고 가능하면 각종 테스트도 함께 돌리는 것을 권합니다. 그러면 로컬에서 Rust 야간 버전을 전환할 필요도 없고 경계 사례에 발목 잡힐 일도 없으며, 변경 사항을 올렸을 때 문제가 있으면 지속적 통합이 막아 주므로 현재로서는 이것이 가장 편안한 개발자 경험 방식입니다. 이번 이야기는 여기까지 하고, 다음에 시간이 나면 다시 만져 보겠습니다.