私はもう長いこと Rust が好きです。その長所は明らかですが、短所も同じくらい明らかです。ガベージコレクションなしのメモリ安全性、ゼロコスト抽象化、並行処理の安全性、現時点ではほぼ最高といえるツールチェーンと周辺エコシステム、クラウド上のウェブサーバーからマイクロコントローラーまでを網羅する圧倒的な適用範囲、そして非常に優れたエラー処理設計があります。一方の短所は?学習曲線が険しいこと?所有権や借用といったモデルの制約を理解しにくいこと?コードを書くのに時間がかかること?
長い間、私たちはこれらを Rust の欠点だと考えてきました。しかし実際には、最初の二つは思考力や認識力を鍛えることで解決できます。それでもコンパイルの遅さだけは、ずっと私の作業の流れを鈍らせてきました。数年前までは、それでも問題なかったように思います。AI が押し寄せてくる前の私には、何よりも忍耐力があり、一つのアルゴリズムや機能を夜明けまで書き続けることも珍しくありませんでした。でも今は? 自分が変わっていないとは、とても言えません。まったく我慢が利かなくなり、Rust のコードをどう書くか考える気にもなれず、Cargo の延々と続く進行状況表示も待っていられません。特につらいのは ld の段階で、進捗すら表示されず、毎回ただ固まったように待たされます。これは本当につらいことです。
これらを解決する方法は本当にないのでしょうか。実は、あります。1か月ほど前、ワークフローの最適化など、Rust の開発プロセスを高速化する方法をいくつか試してみました。しかし実際には、待ち時間のほとんどが Cargo に集中しています。ここを解決できなければ、根本的な改善にはなりません。そこで今回は、Rust 開発における Cargo.toml の設定調整と、それを支える周辺設定について少しお話しします。
バックエンド理論
Rust の設計では、LLVM は多少手抜きな部分もありますが、選択としては非常に適切です。Go のように自前で機械語への変換プロセスを管理するのとは異なり、LLVM の大規模なエコシステムに成熟した最適化を任せることは実際に有益です。Rust のコンパイル全体の流れは大まかに次のように説明できます。ソースコードはまず字句解析と構文解析を経て抽象構文木(AST)を生成し、その後マクロ展開と HIR の降格(平坦化)を行います。続いて通常の型チェックと少量の借用チェックが行われ、最終的に中間表現(MIR)が生成されます。ここまでの工程はすべて Rust コンパイラのフロントエンドが担当します。
MIR の後の処理は LLVM に任せます。たとえば MIR を LLVM IR に変換し、LLVM が O0 から O3 までの最適化パスを実行します。最後に対象プラットフォーム用の機械語を生成し、リンクャへ渡してバイナリ実行ファイルに組み立てます。
では、いったい何が問題なのでしょうか。答えは実に単純です。LLVM は非常に重量級の基盤であり、本番環境ではその重さがむしろ適切です。コンパイル時間と引き換えに実行時間を短縮するのは優れた考え方です。LLVM は上位層の Rust をはじめ、C、C++、Swift など数多くの言語を橋渡ししています。つまり、その最適化パイプラインは「最適な機械語を生成する」ために設計されており、「コンパイルを素早く終える」ためのものではありません。release モードで数十個もの最適化パスを一通り実行すると、非常に長い時間がかかります。debug モードの O0 であっても、LLVM は中間表現の生成から機械語の生成まで一連の工程をすべて通る必要があり、この工程自体が決して軽量ではありません。さらに、Rust のジェネリクスの単相化によってコンパイル時に大量のコードが展開されるため、LLVM に渡される中間表現はソースコードから想像するよりはるかに大きくなり、それに伴って LLVM の処理量も当然膨れ上がります。
Cranelift
つまり本質的に、コンパイルが遅い時間の大部分は Rust 自身のフロントエンドではなく、LLVM という「重量級バックエンド」に費やされています。ではここで問題です、これを捨てることはできないのでしょうか。 Cranelift というバックエンドが、まさにこの需要のために作られています。もとは Cretonne という名で 2016 年に始まり、Bytecode Alliance が開発しました。最初は Wasmtime のためにコード生成バックエンドで、その後 Rust 公式に取り込まれ、オプションの codegen バックエンドになりました。


では、Cranelift は具体的にどこで速さを発揮するべきなのでしょうか。最適なのは開発段階です。この段階では、実行効率を限界まで最適化した、ほぼ完璧なマシンコードなど必要ないかもしれません。必要なのは、ただ素早いフィードバックだけなのかもしれません。この出来が今ひとつなマシンコードが、LLVM によって正式に生成されたマシンコードと意味的に等価でさえあれば、それで十分です。初期の Cranelift は多くのエッジケースがあったため、実際にはこれを実現できませんでした。今でも残ってはいるものの大幅に改善され、Cranelift では動くのに LLVM では壊れる事態に遭遇する確率は、Rust を書いていて rustc の内部コンパイラーエラーを引き起こす確率と同じくらいになっています。LLVM は極限まで最適化されたマシンコードを生成するため、ループ展開、ベクトル化、定数伝播、不要コード除去など、何十もの最適化工程を実行し、幾重にもコードを磨き上げます。一方、Cranelift の設計思想はまったく異なり、こうした最適化工程を大幅に削減して、最も基本的なレジスター割り当てと命令選択だけを行い、反復を重ねることなく、一度の線形走査でコード生成を完了します。また、中間表現の設計もより軽量で、上位の中間表現からマシンコードへ高速に変換するために特化しており、何十年分もの汎用化の重荷を抱える LLVM IR とは対照的です。
利点は話し終えました、では代償は?まず明らかなのは、Cranelift が吐くコードは LLVM のものより実行が遅いということです。場面によりますが、だいたい 10%~30% ほど遅くなります。ですが割り切ってしまえば、これは開発段階ではまるで重要でないと分かります。そんな速さが何の役に立つのでしょう?ベンチマークでも回すのか、CI の release ビルドでもするのか。私は 、cargo build が速く終わってほしいだけです、ロジックが出ているかどうか見たいだけです。しかも賭けてもいいですが、あなたの書くプログラムの大半が計算資源を 8 割以上の時間埋め尽くすなんてことはあり得ません。実際の処理が流れ込んでこそですが、開発中にその処理がどれほどあるでしょう?CPU はおそらく終始 、むしろ結果を見てロジックを確かめたいのはこちらの方です。ならばコンパイル時間を実行効率と引き換えにするその計算、開発ループの中では逆向きに勘定すべきではないでしょうか。
コード生成単位
次に codegen-units について説明します。これは、コンパイラーが crate をいくつの最小単位に分割し、バックエンドで並列処理させるかを制御するパラメーターです。既定値はデバッグモードでは 256、リリースモードでは 16 です。数値が大きいほど並列度が上がり、複数の CPU コアを同時に使ってバックエンドのコード生成を実行できるため、コンパイルが速くなります。ただし、各単位が個別に最適化されることで LLVM(または Cranelift)から見えるコンテキストが小さくなり、単位をまたぐインライン化や最適化の機会が減るため、最適化の効果は低下します。
しかし、実際のリリースビルドでは、通常はもう一方の極端な設定である codegen-units = 1 を使うべきです。そうして初めて、成果物を最大限に最適化できます。せっかく Rust を使うのなら、コンパイル時間と引き換えに実行時性能を高めるのは当然ではないでしょうか。
最適化レベル
もう一つ見落とされがちですが調整可能な設定が opt-level です。デフォルト値は "3" のはずですが、リリースビルドでは "z" にするのが一般的です。コードを変更せずに成果物のサイズを小さくできるのですから、使わない手はありません。ただし開発モードでは、最速のビルドを実現するために最適化を完全に無効化し、"0" に設定するべきです。
もう一つの小技として、Cargo.toml では依存関係と自分のコードに異なる最適化レベルを設定できます:
[profile.dev.package."*"]
opt-level = 3
これにより、サードパーティー依存関係を O3 でコンパイルできます。時間が増えるのは最初のクリーンビルドだけで、その後はインクリメンタルビルドになります。外部依存関係は通常それほど頻繁に更新されないため、依存関係には O3、独自のアプリケーションコードには O0 を使うことで、たいていは速度とバイナリサイズのバランスが取れた快適な開発モードを実現できます。ただしリリースモードでは、やはり O3 または Z で最適化を最大まで引き上げることをお勧めします。これについては特に議論の余地はありません。
リンク時最適化
LTO(リンク時最適化)も、メモリとコンパイル時間を大量に消費する機能ですが、ほとんどのプロジェクトではリリースビルドでの有効化が推奨されています。通常のコンパイルでは各クレートが個別に最適化されるため、コンパイラのバックエンドからはクレート間の呼び出し関係が見えず、一部のクレート横断インライン化や不要コード除去を実行できません。このようなケースは非常に多くあります。LTO はこの境界を取り払い、リンク時に全クレートの中間表現を最適化器へ渡して、一度の大域的な最適化を行います。ただし、考えなしにプロファイルへ直接 lto = true を追加してはいけません。Rust のコンパイルが途方もなく遅くなるため、よく確認したうえでリリースプロファイルを使用するときだけ有効にしてください。
デバッグシンボルを削除
ほかのものと同様に、Rust のデバッグ情報とシンボルもここに格納されています。リリースモードで strip を有効にすると、サイズを大幅に削減できます(通常は 50 MB 対 5 MB)。とんでもない差です。シンボルを取り除けば安全性も高まります。というのも、フロントエンドのソースコードが漏洩する原因の大半は、ソースマップを誤って npm に公開してしまうことだからです :(
そのため、開発プロファイルについては特に言うことはありません。デバッグ情報を削除してしまうわけにはいかず、そうすると gdb / lldb で通常どおりデバッグできなくなり、スタックトレースにも意味のある関数名が表示されなくなります。ただし、Arch Linux ではパッケージ作成時に既定で削除してくれる点に注意してください。ここで少し競合が生じ、こちらですでに削除済みのため、後でエラーになる可能性があります。AUR パッケージを書く際は、この手順を明示的にスキップしてください。
パニックを捨てよう!
通常の業務コードに、panic が存在してはなりません。通常の業務コードが実行時にエラーに遭遇した場合、耐障害性を考慮して設計された Err はすべて安全に返されるべきであり、乱暴にパニックさせるべきではありません。React ErrorBoundary と同様、通常のエラーとして処理する必要があります。パニックを発生させるべきなのは、コードがあり得ない状態に入り、しかも回復不能だと確信している場合だけです。私個人の哲学は、パニックを捨てることです。なぜなら、実際の業務コードのテストは三層に分けられるからです。第一層は正常系、第二層はエラー経路(無限にある可能性のうちの一つ)、そして第三層がファジングや衝突テストによる総当たりで見つかる境界事例です。工学的に言えば、正常系は 100% テストでき、エラー経路は一つの分類にある n 種類の変形から一つを選べます。衝突テストは純粋に時間の問題であり、ほとんどの場合は割に合いません。本当に利用者規模が大きくなれば、必要な時期は自分で分かるようになります。私は原則として一切行いません。
したがって、良いコードには、1種類の正常経路を網羅するテストと、少なくとも1つのエラー経路を網羅するテストが必要です。同じ種類のエラー経路は1例だけ網羅すれば、エラーが Err として返されることを検証でき、フォールバック処理を書いて、自然に thiserror で列挙するか、anyhow で捕捉して平坦化・出力・記録できます。要するに、コードそのものが、こうした状況を処理する仕組みを書くよう促すのです。この段階まで到達すれば、panic は不要になり、「理論上は起こり得ない」と考えられます。ただし、それはあくまで理論上の話です。現実には、オペレーティングシステムのエラー、メモリエラー、宇宙線の単一電子によるビット反転、奇妙なオーバーフローなどが存在し、こうした状況をすべて網羅することは永遠にできません。では、なぜパニックを起こさないのでしょうか。それは、こうした状況の90%は、おそらく自分のコードの問題ではないからです。panic の本質は、それが発生すると Rust がコールスタックを1段ずつ遡り、各フレームのデストラクター(drop)を順番に呼び出してリソースを解放することにあります。この処理のために、コンパイラーはビジネスロジックの誤りを特定する追加の unwind テーブルを生成する必要があります。エラー自体が自分のコードに起因しない可能性が高いなら、その情報にどんな価値があるでしょうか。残しておけばビルド成果物も大きくなり、リンカーの負担も増えるため、無効にするのが正解です。コードが十分にテストされ、自信があるなら、panic = abort の設定をお勧めします。
実測
百聞は一見にしかず、これらの組み合わせで実際にどれほど向上するのか、数か月前に作った小さな遊びのプロジェクトを例に見てみましょう。
このプロジェクトの Rust 部分には、依存関係を除いて約3万2千行のソースコードがあります。
Rendering is a protocol, not a render-time computation.
このリポジトリは、実際には多数のサブプロジェクトを含むモノレポですが、その中には典型的な例が2つあります。まず Skeleton パッケージを見ると、その特徴は明らかです。コード量が多く、依存関係がごくわずかです。このパッケージはプロジェクト全体でコード生成の比率が最も高くなるため、Cranelift の強みを特に活かしやすいでしょう。また、このパッケージは非常にクリーンでもあります。ここでいう「クリーン」とは、すべて安全な Rust で書かれているという意味です。
一方、次のコマンドラインインターフェース用パッケージはあまり適していません。依存関係が多いこと自体は大した問題ではなく、理論上はむしろ効率の高さを示しやすくなりますが、ここには典型的な二者択一があります。左上を見ると、依存関係 ring が任意として指定されています。これは、このプロジェクトがもともと aws-lc-rs を使っていたためです。どちらも Rust の暗号アルゴリズム用バックエンドです。では、なぜ任意にするのでしょうか。それは、ring が純粋な Rust で書かれているのに対し、もう一方は外部関数インターフェース経由で取り込まれるアセンブリ実装で、x86 や arm64 などの主要な中央処理装置アーキテクチャ向けにアセンブリレベルで高速化されているからです。しかし、それこそが弱点でもあります。Cranelift の魔法が通用するのは純粋な Rust に限られ、不安全なコードや、外部関数インターフェース経由の C、アセンブリなどを導入した途端、Cranelift の互換性は実際には極端に低くなります。
とはいえ、この問題にも解決策はあります。cfg でバックエンドを選択し、Cranelift モードでは ring を指定してコンパイルすればよいのです。前述のとおり開発用とリリース用のプロファイルを設定してから CLI のコンパイル時間を簡単に比較すると、この条件では開発ビルドがリリースビルドより少なくとも3倍高速になります。しかも、これは増分コンパイルを使わないコールドビルドでの結果です。さらに、最適化レベルを O0 にしてリンク時最適化を無効にすれば、以後の増分更新では開発用プロファイルがリリース用プロファイルより数十倍以上高速になるはずです。リンク時最適化などの仕組みは、実質的に各パッケージ間の境界を平坦化することで成り立っているため、すべてが一体化すると、一か所のコードを変更しただけでも全体を再コンパイルする必要が生じ、増分更新が正しく機能しなくなります。


総合結果を見る限り、この 2 つは実のところ大差なく、質的な変化とまでは言えないものの、違いは間違いなくはっきり体感できます。主な理由は Apple Silicon があまりにも強力で、M シリーズチップのシングルコア性能もメモリ帯域幅も桁外れに高く、計算負荷と I/O 負荷の両方が大きいコンパイル処理がちょうどその恩恵を受けるからです。Linux で試せば通常は差がさらに広がりますが、MacBook に Asahi Linux などを入れて比べるなら、間違いなく Linux の勝ちです。
旧式のリンカー
Linux では、Rust はデフォルトで GNU ld(bfd)を使用します。そう、最も古くて遅い、あのリンカーです。シングルスレッドで動作し、シンボル解決と再配置もどちらも直列走査で処理するため、プロジェクトが大きくなると目に見えて足を引っ張ります。Linux では、@Rui Ueyama が開発した mold を試せます。設定はとても簡単で、.cargo/config.toml に 1 行追加するだけです。
[target.x86_64-unknown-linux-gnu]
linker = "clang"
rustflags = ["-C", "link-arg=-fuse-ld=mold"]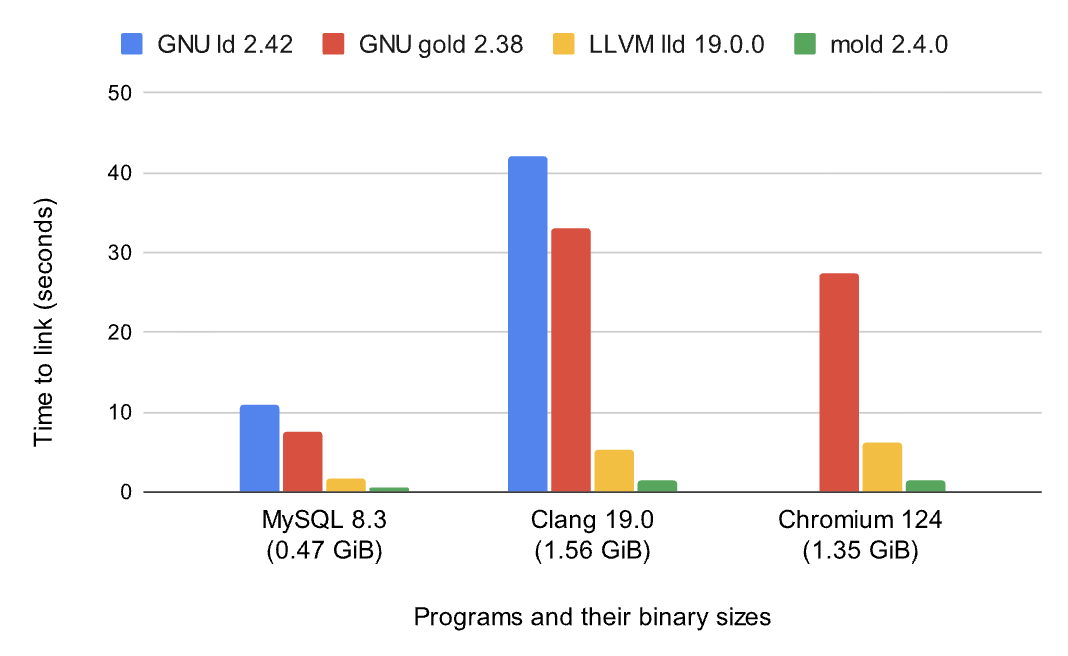
性能向上はかなり顕著ですが、残念ながら macOS では商用プロジェクトの sold しかありません。ただし幸い、macOS の lld も Apple 純正の ld64 も元からそれほど遅くなく、特に Xcode 15 以降の新しいリンカーは劇的に高速化されています。唯一の欠点は、macOS の無人 CI では更新のたびに sudo を使って規約に同意しなければならず、そのせいで CI の定期ジョブが何度も失敗したことです。
MUSL と glibc
私自身は で、GNU glibc は大嫌いなのですが、開発中はやはり x86_64-unknown-linux-gnu をおすすめします。なぜかというと、速いからです。MUSL 最大の売りは完全に静的リンクされたバイナリを生成できること——システム上のどの動的ライブラリにも依存せず、ビルドしたものをどの Linux マシンにコピーしてもそのまま動くので、コンテナや組み込みには特に向いています。ただし遅さの原因もその静的リンクにあります。リンカがすべてを一つに詰め込む必要があるため、リンク段階の作業量が動的リンクよりかなり大きくなるのです。
ただし、macOS を使っているなら朗報です。この点はまったく心配する必要がなく、現時点では aarch64-apple-darwin が唯一の選択肢です。macOS は設計上、完全な静的リンクに対応していませんが、コンパイル速度という観点では、むしろ好都合です。そのため、開発用プロファイルでは Linux 上で GNU libc、macOS 上で libSystem を使い、リリース用プロファイルでは macOS と Linux のどちらでも musl を使えます。macOS が既定で選択するリンカーとアーカイバーの都合上、注意すべき点は .cargo/config.toml の設定が必要になるかもしれないことだけです。
[target.x86_64-unknown-linux-musl]
linker = "x86_64-linux-musl-gcc"
ar = "x86_64-linux-musl-ar"
ちなみに、Zig は絶対に使わないでください。現在、Rust Nightly 上の zbuild には深刻な問題があります。クロスコンパイルが必要で、ホストが Linux x86 なら、Docker と組み合わせてビルドする cross がおすすめです。環境が一式そろっていて、とても便利です。glibc を好む場合にも適しています。glibc が保証するのは後方互換性だけなので、一般的には、Debian のメジャーリリースを二つさかのぼり、そこに搭載された glibc のバージョンでコンパイルします。そうしないと、新しすぎる glibc のせいで多くのマシン上で動かなくなります。これは新機能を使ったからではなく、単に文字列内のバージョンを判定して腹を立てさせてくるだけです。ホストが Mac なら、rustup ネイティブの target + cargo build --release を使ってください
UPXは悪いもの
もう一つ議論する価値があるのが、UPX の利用についてです。musl が好きだと言っておきながら小さなバイナリサイズも追求するのは、実のところかなり矛盾していて、筋が通っていないように聞こえるでしょう……
                 ooooo     ooo  ooooooooo.  ooooooo  ooooo
                 `888'     `8'  `888   `Y88. `8888    d8'
                  888       8    888   .d88'   Y888..8P
                  888       8    888ooo88P'     `8888'
                  888       8    888           .8PY888.
                  `88.    .8'    888          d8'  `888b
                    `YbodP'     o888o       o888o  o88888o


                    The Ultimate Packer for eXecutables
   Copyright (c) 1996-2026 Markus Oberhumer, Laszlo Molnar & John Reiser
                           https://upx.github.io
しかし実際には、UPX の存在によってこの問題は解決できます。UPX はバイナリを圧縮し、そこに展開用スタブを組み合わせる仕組みで、実行時にはまずメモリ上で展開してから処理を開始します。これによりバイナリのサイズを元の約 30~50% まで縮小できるため、容量面での利点は非常に大きくなります。ただし、まさにこの仕組みのため、UPX と GNU glibc の動的リンクを組み合わせると深刻な問題が生じます。glibc を動的リンクしたバイナリには特殊なセクションや動的読み込みの仕組みが含まれており、UPX による圧縮でそれらの構造が壊れ、実行時に動的ライブラリを見つけられなくなる可能性があります segment fault。一方、musl は UPX と非常に相性がよく、もともと完全静的リンクで内部構造も安定しているため、UPX による圧縮と展開を問題なく行えます。したがって、musl のリリース CI に UPX の工程を追加するのは大きな利点になります。
また、UPX は濫用すべきではなく、長時間実行するタスクか実行頻度の低いタスクにしか向きません。長時間実行するタスクに適しているのは、UPX が起動時に一度メモリ上で展開を行うためです。この処理は完全に自動で、コールドスタートの遅延もわずかですが、高頻度のパスでは依然として致命的になり得ます。そのため、一度起動した後はバックグラウンドで動き続けるタスクには最適です。ただし、docker イメージ内の長時間稼働するサービスのパッケージへ無条件に UPX を適用することは勧めません。実質的にはメモリと引き換えにディスク容量を減らす行為で、まったく割に合わないうえ、コンテナの Layer 圧縮も配布時のダウンロード容量を減らすという点では UPX と同じ効果を持つからです。むしろ一部の CLI 用途にはお勧めできます。ディスク容量を大幅に節約でき、起動時の展開時間もほぼ気にならず、musl も本来 CLI に適しています。そうでなければ AUR ヘルパーを名指しで批判したいところです。go で書かれたあれは静的リンクされておらず、以前 ArchLinux 上で yay が動的ライブラリを見つけられず壊れたことがありました。それ自体がシステム管理ツールなので打つ手がなく、別途 LiveISO を起動し、最後は chroot してシステムを復旧するしかありませんでした。
まとめ
最後に、こうした便利な設定を使えば開発用プロファイルとリリース用プロファイルをすぐに区別でき、その効果はプロジェクトのコードが増えるほど明確になりますが、それでも Rust 安定版の LLVM ビルドを実行する継続的インテグレーションをもう一つ用意し、できれば各種テストも一緒に走らせることをお勧めします。そうすればローカルの Rust 夜間版を切り替える必要もなく、境界事例に足をすくわれることもなく、問題がある変更はプッシュした時点で継続的インテグレーションに止めてもらえるため、現時点ではこれが最も快適な開発者体験です。それでは今回はここまでにして、また時間があるときにいじりましょう。