J’aime Rust depuis longtemps. Ses qualités sont évidentes, mais ses défauts le sont tout autant. Sécurité de la mémoire sans ramasse-miettes, abstractions sans surcoût, sûreté des accès concurrents, chaîne d’outils et écosystème sans doute parmi les meilleurs à l’heure actuelle, champ d’application extrêmement vaste — des serveurs web infonuagiques aux microcontrôleurs — et excellente conception de la gestion des erreurs. Ses défauts ? Une courbe d’apprentissage abrupte ? Des contraintes de modèles comme la propriété et l’emprunt difficiles à comprendre ? Une écriture du code plutôt lente ?
Pendant longtemps, nous avons tous considéré ces aspects comme des défauts de Rust. En réalité, les deux premiers peuvent être surmontés en entraînant notre façon de penser et de comprendre, mais la lenteur de la compilation continue de ralentir mon flux de travail. Il y a quelques années, tout cela semblait encore acceptable : avant que l’AI ne déferle, j’avais surtout de la patience et je passais souvent la nuit sur un algorithme ou une fonctionnalité. Mais aujourd’hui ? Je peux difficilement prétendre ne pas avoir changé. Je suis devenu totalement impatient : je n’ai plus aucune envie de réfléchir à la façon d’écrire du code Rust, je ne supporte plus l’interminable barre de progression de Cargo et, surtout, l’étape ld n’affiche même aucun avancement—à chaque fois, tout reste simplement bloqué. C’est vraiment pénible.
N’existe-t-il donc vraiment aucune solution à tout cela ? En réalité, si. Il y a environ un mois, j’ai essayé plusieurs moyens d’accélérer mon processus de développement en Rust, notamment en optimisant mon flux de travail. Mais, dans les faits, l’attente venait presque toujours de Cargo. Tant que ce problème ne sera pas résolu, le reste ne fera que traiter les symptômes. Je vais donc profiter de l’occasion pour parler brièvement de l’optimisation de la configuration de Cargo.toml dans le développement en Rust, ainsi que des réglages complémentaires qui l’accompagnent.
Théorie du backend
Dans la conception de Rust, LLVM peut paraître un peu négligent, mais c’est un très bon choix. Contrairement à Go qui gère lui‑même le processus complet de conversion en code machine, Rust confie à l’énorme écosystème LLVM les optimisations matures, ce qui est en réalité très avantageux. Le processus de compilation de Rust peut être décrit grossièrement ainsi : le code source passe d’abord par une analyse lexicale et syntaxique qui génère un arbre syntaxique abstrait (AST), puis on effectue l’expansion des macros et le « lowering » du HIR (déflattening). Ensuite, on réalise la vérification de type habituelle ainsi qu’une petite vérification d’emprunt, pour finalement produire la représentation intermédiaire (MIR). Jusqu’à ce point, tout le travail est effectué par le front‑end propre au compilateur Rust.
Après le MIR, le reste du traitement est confié à LLVM : le MIR est traduit en LLVM IR, puis LLVM exécute sa série de passes d’optimisation (de O0 à O3). Enfin, le code machine cible est généré et remis au linker qui le rassemble en un exécutable binaire.
Où se situe donc exactement le problème ? La réponse est en réalité très simple : LLVM est une infrastructure très lourde, et ce poids est justifié dans un environnement de production. Échanger du temps de compilation contre du temps d’exécution est une excellente philosophie. LLVM fait le lien avec de nombreux langages de haut niveau, notamment Rust, C, C++ et Swift. Cela signifie que sa chaîne d’optimisation est conçue pour « produire le meilleur code machine possible », et non pour « terminer rapidement la compilation ». Exécuter ses dizaines de passes d’optimisation en mode release prend énormément de temps. Même à O0 en mode debug, LLVM doit encore parcourir l’intégralité du processus de génération de la représentation intermédiaire et du code machine, un processus qui n’a lui-même rien de léger. À cela s’ajoute la monomorphisation des génériques de Rust, qui développe une grande quantité de code pendant la compilation : la représentation intermédiaire transmise à LLVM est donc bien plus volumineuse que ne le laisse penser le code source, ce qui accroît naturellement d’autant la charge de travail de LLVM.
Cranelift
Au fond, une bonne partie de la lenteur de compilation ne se joue donc pas dans le frontend de Rust lui-même, mais dans LLVM, ce « backend lourd ». D'où la question : serait-il possible de s'en débarrasser ? Il existe justement un backend nommé Cranelift, conçu pour ce besoin précis. Il s'appelait d'abord Cretonne, lancé en 2016, développé par la Bytecode Alliance, un backend de génération de code pensé au départ Wasmtime ; il a ensuite été repris par le projet Rust comme backend codegen optionnel.


Alors, à quel moment Cranelift est-il censé être plus rapide exactement ? C’est pendant la phase de développement qu’il est le plus avantageux. À ce stade, vous n’avez peut-être absolument pas besoin d’un code machine presque parfait, dont l’efficacité d’exécution aurait été optimisée à l’extrême ; vous avez peut-être seulement besoin d’un retour rapide. Il suffit que ce code machine moins performant soit sémantiquement équivalent à celui correctement produit par LLVM. Les premières versions de Cranelift n’y parvenaient pas vraiment en raison de nombreux cas limites. Il en subsiste encore aujourd’hui, mais la situation s’est beaucoup améliorée : la probabilité que Cranelift fonctionne alors que LLVM échoue est désormais à peu près équivalente à celle de déclencher une erreur interne de rustc en écrivant du Rust. Pour générer un code machine optimisé à l’extrême, LLVM exécute des dizaines d’étapes d’optimisation, comme le déroulage des boucles, la vectorisation, la propagation des constantes ou l’élimination du code mort… et bien d’autres encore, affinant le code couche après couche. Cranelift suit une philosophie de conception totalement différente : il réduit radicalement ces étapes d’optimisation, ne réalise que l’allocation élémentaire des registres et la sélection des instructions, puis achève la génération du code en un seul balayage linéaire, sans itérations répétées. Sa représentation intermédiaire est également plus légère et spécialement conçue pour traduire rapidement une représentation intermédiaire de plus haut niveau en code machine, contrairement à LLVM IR, qui porte le poids de plusieurs décennies de généralisation.
Voilà pour les avantages -- et le prix ? L'évidence d'abord : le code produit par Cranelift s'exécute plus lentement que celui de LLVM, environ 10%~30% plus lentement selon les cas. Mais dès qu'on lâche prise, on s'aperçoit que cela n'a aucune importance en phase de développement. À quoi me servirait cette vitesse ? Je fais un benchmark, ou une build release en CI ? Je veux juste que cargo build finisse plus vite, pour voir si la logique tient. Et je parie que la plupart des programmes que vous écrivez ne peuvent pas saturer les ressources de calcul plus de 80% du temps -- il faudrait qu'il y ait de la vraie charge, et quelle charge y a-t-il pendant que vous développez ? Votre CPU doit du début à la fin, alors que c'est moi qui ai besoin de voir le résultat et de vérifier la logique. Ce troc du temps de compilation contre l'efficacité à l'exécution, ne faudrait-il donc pas faire le compte à l'envers à l'intérieur de la boucle de développement ?
Unités de génération de code
Parlons également de codegen-units. Ce paramètre détermine en combien d’unités minimales le compilateur divise une crate afin que le backend les traite en parallèle. Par défaut, il y en a 256 en mode débogage et 16 en mode production. Plus ce nombre est élevé, plus le parallélisme est important et plus la compilation est rapide, car plusieurs cœurs du processeur peuvent exécuter simultanément la génération de code du backend. En contrepartie, l’optimisation est moins efficace : chaque unité étant optimisée séparément, LLVM (ou Cranelift) dispose de moins de contexte, ce qui réduit les possibilités de mise en ligne et d’optimisation entre unités.
Cependant, pour une véritable version de production, il convient généralement d’utiliser l’autre valeur extrême, codegen-units = 1. C’est la seule façon d’optimiser au maximum le résultat produit. Après tout, quitte à utiliser Rust, quoi de plus naturel que d’échanger du temps de compilation contre de meilleures performances à l’exécution ?
Niveau d’optimisation
Un autre réglage souvent négligé, mais ajustable, est opt-level. Sa valeur par défaut devrait être "3", mais pour une version de production, il est plus courant de la régler sur "z". Cela réduit gratuitement la taille de l’artéfact sans modifier le code, alors pourquoi s’en priver ? En mode développement, en revanche, elle devrait être réglée sur "0", car désactiver entièrement l’optimisation permet d’obtenir la compilation la plus rapide.
Une autre petite astuce consiste à utiliser Cargo.toml pour définir des niveaux d’optimisation différents pour les dépendances et votre propre code :
[profile.dev.package."*"]
opt-level = 3
Cela permet de compiler les dépendances tierces avec O3, ce qui n’allonge que la durée de la première compilation complète ; les compilations suivantes sont incrémentales. Comme les dépendances externes sont généralement peu souvent mises à jour, utiliser O3 pour celles-ci et O0 pour votre propre code applicatif offre habituellement une bonne expérience en mode développement, avec un compromis équilibré entre vitesse et taille du binaire. En mode production, je recommande toutefois toujours de pousser l’optimisation au maximum avec O3 ou Z — il n’y a pas grand-chose d’autre à ajouter.
Optimisation à l'édition de liens
La LTO (optimisation à l’édition de liens) est une autre fonctionnalité très gourmande en mémoire et en temps de compilation, mais son activation est recommandée pour les versions de production de la plupart des projets. Lors d’une compilation normale, chaque crate est optimisée séparément : le backend du compilateur ne voit donc pas les relations d’appel entre les crates et ne peut pas effectuer certaines mises en ligne ni éliminations de code mort entre crates, alors que ces situations sont très fréquentes. La LTO supprime cette frontière et fournit à l’optimiseur la représentation intermédiaire de toutes les crates au moment de l’édition de liens afin d’effectuer une passe d’optimisation globale. N’ajoutez toutefois jamais lto = true directement à un profil sans réfléchir, car la compilation de Rust deviendrait désespérément lente ; vérifiez soigneusement la configuration et ne l’activez que dans le profil de production.
Éliminer les symboles de débogage
Comme pour le reste, les informations de débogage et les symboles de Rust sont stockés ici. Activer strip en mode de publication permet de réduire considérablement la taille (généralement 50 Mo contre 5 Mo), soit une différence proprement hallucinante. Supprimer les symboles est également plus sûr, puisque les fuites de code source frontal proviennent le plus souvent de tables de correspondance publiées par inadvertance sur npm :(
Il n’y a donc pas grand-chose à dire concernant le profil de développement : impossible de supprimer les informations de débogage, puisque cela empêcherait de déboguer normalement avec gdb / lldb et ferait disparaître les noms de fonctions pertinents de la trace d’appels. Attention toutefois : Arch Linux les supprime par défaut lors de la création d’un paquet. Cela crée un léger conflit ici, car nous les avons déjà supprimées et une erreur peut alors survenir plus tard. Lors de la création d’un paquet AUR, pensez à ignorer explicitement cette étape.
Abandonnez les paniques !
Dans du code métier ordinaire, panic ne devrait pas exister. Lorsque du code métier normal rencontre une erreur à l’exécution, toute valeur Err pour laquelle une tolérance aux pannes a été prévue devrait être renvoyée sans risque, plutôt que de provoquer brutalement une panique. Comme avec React ErrorBoundary, elle devrait être traitée normalement comme une erreur. Une panique ne devrait être déclenchée que lorsque le code est certain d’avoir atteint un état impossible et irrécupérable. Ma philosophie personnelle consiste à renoncer aux paniques. Pourquoi ? Parce qu’en pratique, le code métier peut être testé en trois couches : d’abord le chemin nominal, ensuite un chemin d’erreur — une possibilité parmi une infinité — et seulement enfin les cas limites recensés exhaustivement par des tests aléatoires ou de collision. Du point de vue de l’ingénierie, le chemin nominal peut être testé à 100 % ; pour les chemins d’erreur, on peut retenir une variante parmi les n d’une même catégorie. Les tests de collision ne sont qu’une question de temps et n’en valent généralement pas la peine. Lorsque votre nombre d’utilisateurs aura réellement augmenté, vous saurez vous-même quand ils seront nécessaires ; en règle générale, je n’en fais jamais.
Un bon code doit donc comporter des tests couvrant une catégorie de chemins de réussite et au moins un chemin d’erreur. Pour une même catégorie de chemins d’erreur, un seul cas suffit à vérifier que l’erreur est renvoyée sous forme d’Err ; on peut alors écrire une logique de repli, puis tout naturellement l’énumérer avec thiserror ou l’intercepter avec anyhow, l’aplatir, l’afficher et le journaliser. En bref, votre code vous oblige à créer des mécanismes pour gérer ces situations. Une fois ce niveau atteint, panic ne vous sert plus à rien : vous pouvez considérer cela comme « théoriquement impossible », mais seulement en théorie. Dans le monde réel, il reste les erreurs du système d’exploitation, les erreurs de mémoire, les inversions de bit provoquées par un électron issu du rayonnement cosmique, les débordements étranges… Vous ne pourrez jamais couvrir toutes ces situations. Alors pourquoi éviter de déclencher une panique ? Parce que ces situations ont de fortes chances — 90 % — de ne pas être dues à votre code. panic consiste essentiellement, lorsqu’il se produit, à faire remonter Rust dans la pile d’appels, niveau après niveau, en invoquant le destructeur (drop) de chaque cadre pour libérer les ressources. Ce processus oblige le compilateur à générer une table unwind supplémentaire destinée à repérer les erreurs dans votre logique métier. Si l’erreur elle-même ne vient probablement pas de votre code, quelle valeur cette information a-t-elle ? Sa présence augmente aussi la taille de l’artefact compilé et la charge de travail de l’éditeur de liens ; la désactiver est donc la bonne solution. Si votre code est suffisamment testé et que vous avez assez confiance en lui, je recommande de configurer panic = abort.
Tests pratiques
Assez parlé : voyons concrètement les gains apportés par ces combinaisons, en prenant comme référence un petit projet expérimental que j’ai réalisé il y a quelques mois.
La partie Rust de ce projet compte environ 32 000 lignes de code source, sans les dépendances.
Rendering is a protocol, not a render-time computation.
Ce dépôt est en réalité un monodépôt contenant de nombreux sous-projets, mais on peut y distinguer deux exemples représentatifs. Les caractéristiques du paquet Skeleton sautent immédiatement aux yeux : beaucoup de code et très peu de dépendances. La génération de code y occupera la plus grande part de tout le projet, ce qui le rend particulièrement adapté à Cranelift. Ce paquet est également très propre — « propre » signifie ici qu’il est entièrement écrit en Rust sûr.
En revanche, le paquet d’interface en ligne de commande ci-dessous convient assez mal. Son grand nombre de dépendances n’est pas vraiment un problème et devrait même, en théorie, mieux mettre en évidence les gains d’efficacité, mais il présente un choix binaire classique : en haut à gauche, la dépendance ring est indiquée comme facultative. Cela vient du fait que le projet utilisait initialement aws-lc-rs ; les deux sont des moteurs d’algorithmes cryptographiques pour Rust. Mais pourquoi la rendre facultative ? Parce que ring est entièrement écrit en Rust, tandis que l’autre est une implémentation en assembleur intégrée par une interface de fonctions étrangères et spécialement optimisée pour les architectures de processeur courantes telles que x86 et arm64. C’est toutefois aussi son point faible : la magie de Cranelift se limite au Rust pur. Dès que l’on introduit du code non sécurisé, du C ou de l’assembleur par une interface de fonctions étrangères, ou quelque chose de similaire, la compatibilité de Cranelift devient en pratique extrêmement mauvaise.
Ce problème n’est toutefois pas insoluble : il suffit de sélectionner le backend avec cfg et de compiler avec ring en mode Cranelift. Après avoir configuré les profils de développement et de production comme indiqué ci-dessus, une simple comparaison de la compilation du CLI montre que, dans ces conditions, la version de développement est au moins trois fois plus rapide que celle de production, même lors d’une compilation à froid sans traitement incrémental. Avec le niveau d’optimisation O0 et l’optimisation à l’édition des liens désactivée, le profil de développement devrait même être des dizaines de fois plus rapide que celui de production lors des mises à jour incrémentales suivantes. En effet, des techniques comme l’optimisation à l’édition des liens reposent sur l’aplatissement des frontières entre les différents paquets ; une fois tous les éléments fusionnés en un seul bloc, la modification d’une portion de code impose de tout recompiler et empêche le bon fonctionnement des mises à jour incrémentales.


Dans l’ensemble, les résultats montrent qu’il y a en réalité peu de différence entre les deux. On ne peut pas parler de changement qualitatif, mais l’écart reste incontestablement perceptible. Cela tient surtout à la puissance d’Apple Silicon : les puces de série M offrent des performances monocœurs et une bande passante mémoire démesurées, dont la compilation, à la fois très gourmande en calcul et en E/S, profite pleinement. Sous Linux, l’écart serait généralement encore plus marqué ; mais avec une distribution comme Asahi Linux installée sur un MacBook, Linux l’emporterait sans aucun doute.
L’éditeur de liens obsolète
Sous Linux, Rust utilise GNU ld (bfd) par défaut — oui, le plus ancien et le plus lent des éditeurs de liens. Il est monothread, et la résolution des symboles comme les relocalisations reposent sur des parcours séquentiels, si bien qu’il devient rapidement un frein lorsque le projet prend de l’ampleur. Sous Linux, vous pouvez essayer mold, écrit par @Rui Ueyama ; sa configuration est très simple puisqu’il suffit d’ajouter une ligne dans .cargo/config.toml.
[target.x86_64-unknown-linux-gnu]
linker = "clang"
rustflags = ["-C", "link-arg=-fuse-ld=mold"]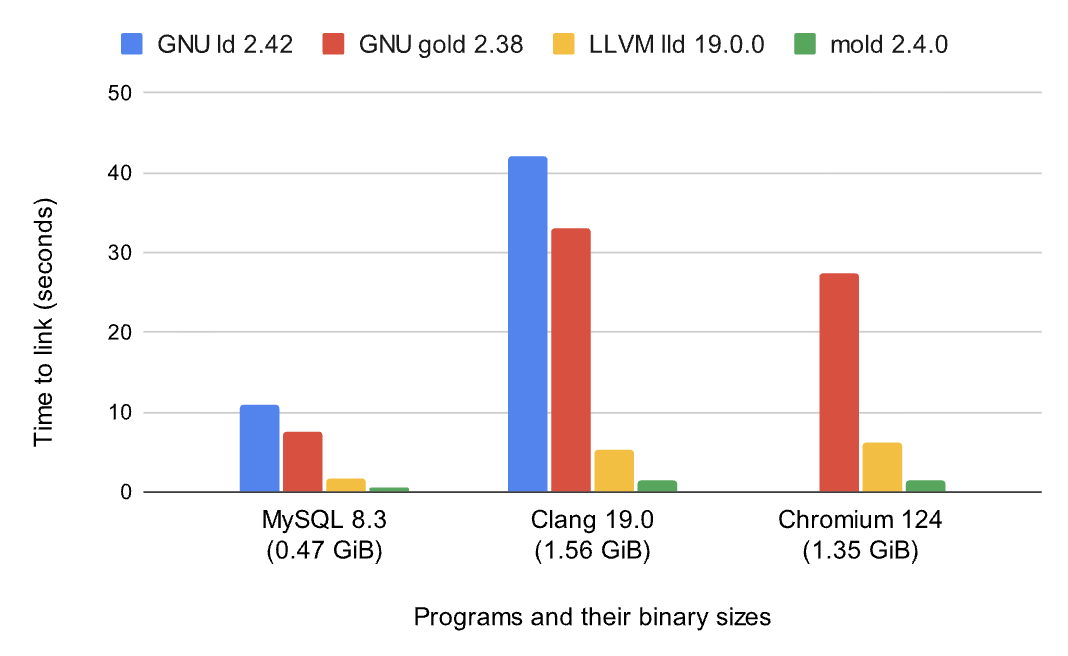
Le gain est très net, mais malheureusement, le seul choix sous macOS est sold, un projet commercial. La bonne nouvelle, c’est que lld sous macOS et ld64 fourni par Apple sont déjà plutôt rapides, surtout le nouvel éditeur de liens introduit avec Xcode 15, qui apporte une accélération spectaculaire. Son seul défaut est que les systèmes d’intégration continue macOS sans surveillance doivent accepter un accord avec sudo après chaque mise à jour, ce qui a fait échouer plusieurs fois mes tâches d’intégration continue planifiées.
MUSL contre glibc
Je suis moi-même un et je déteste GNU glibc, mais pour le développement je vous recommande quand même x86_64-unknown-linux-gnu. Pourquoi ? Parce que c'est rapide. Le grand argument de vente de MUSL, c'est de pouvoir produire des binaires entièrement liés en statique — sans dépendre d'aucune bibliothèque dynamique du système : vous copiez le binaire compilé sur n'importe quelle machine Linux et il tourne, ce qui convient particulièrement aux conteneurs et à l'embarqué. Mais la lenteur vient elle aussi de cette liaison statique : l'éditeur de liens doit tout empaqueter, et la phase de liaison représente donc bien plus de travail qu'en liaison dynamique.
La bonne nouvelle, toutefois, c’est que si vous utilisez macOS, vous n’avez absolument pas à vous en préoccuper : aarch64-apple-darwin est actuellement le seul choix possible. Par conception, macOS ne prend pas en charge l’édition de liens entièrement statique, ce qui est en réalité avantageux du point de vue de la vitesse de compilation. Le profil de développement utilise donc GNU libc sous Linux et libSystem sous macOS, tandis que le profil de publication peut utiliser musl aussi bien sous macOS que sous Linux. En raison des choix par défaut de macOS pour l’éditeur de liens et l’archiveur, le seul point à noter est qu’il faudra peut-être configurer .cargo/config.toml.
[target.x86_64-unknown-linux-musl]
linker = "x86_64-linux-musl-gcc"
ar = "x86_64-linux-musl-ar"
Au passage, n’utilisez surtout pas Zig : zbuild rencontre actuellement de gros problèmes avec Rust Nightly. Pour une compilation croisée depuis un hôte Linux x86, je recommande cross avec Docker ; cela fonctionne très bien et fournit des environnements complets. C’est également un excellent choix si vous préférez glibc. Comme glibc ne garantit que la rétrocompatibilité, la règle habituelle consiste à compiler avec la version de glibc fournie par une édition de Debian antérieure de deux versions majeures ; sinon, une glibc trop récente empêchera le programme de fonctionner sur un grand nombre de machines. Ce n’est pas parce qu’une nouvelle fonctionnalité a été utilisée : il se contente de vérifier la version inscrite dans une chaîne de caractères pour vous contrarier. Si l’hôte est un Mac, utilisez le target + cargo build --release natif de rustup
UPX est une mauvaise chose
Un autre point qui mérite d’être abordé concerne l’utilisation d’UPX ; je sais que j’ai dit aimer musl, mais vouloir en même temps obtenir un binaire de petite taille est en réalité assez contradictoire et ne semble guère logique…
                 ooooo     ooo  ooooooooo.  ooooooo  ooooo
                 `888'     `8'  `888   `Y88. `8888    d8'
                  888       8    888   .d88'   Y888..8P
                  888       8    888ooo88P'     `8888'
                  888       8    888           .8PY888.
                  `88.    .8'    888          d8'  `888b
                    `YbodP'     o888o       o888o  o88888o


                    The Ultimate Packer for eXecutables
   Copyright (c) 1996-2026 Markus Oberhumer, Laszlo Molnar & John Reiser
                           https://upx.github.io
En pratique, UPX permet toutefois de résoudre ce problème. Son principe consiste à compresser le binaire, puis à l’envelopper dans une amorce de décompression : lors de l’exécution, il est d’abord décompressé en mémoire avant d’être lancé. Sa taille peut ainsi être réduite à environ 30 à 50 % de l’original, ce qui procure un avantage considérable. Mais c’est précisément pour cette raison que l’association d’UPX et de l’édition de liens dynamique avec GNU glibc peut poser de sérieux problèmes : les binaires liés dynamiquement à glibc contiennent des sections particulières et des mécanismes de chargement dynamique dont UPX risque d’endommager les structures pendant la compression, empêchant alors de trouver les bibliothèques dynamiques à l’exécution segment fault. À l’inverse, musl convient parfaitement à UPX : ses binaires sont déjà entièrement liés statiquement et leur structure interne est stable, ce qui permet à UPX de les compresser et de les décompresser proprement. Ajouter une étape UPX à l’intégration continue des versions de musl constitue donc un véritable atout.
Il ne faut pas non plus abuser d’UPX, qui ne convient qu’aux tâches longues ou peu fréquentes. Les tâches longues s’y prêtent parce qu’au démarrage, UPX doit décompresser une fois le programme en mémoire ; ce processus est entièrement automatique et n’ajoute qu’un léger délai au démarrage à froid, mais il peut tout de même être rédhibitoire sur un chemin très fréquenté. UPX convient donc parfaitement à une tâche lancée une seule fois, puis laissée en arrière-plan. Je déconseille toutefois de l’appliquer aveuglément aux paquets de services de longue durée dans des images docker : cela revient à échanger de la mémoire contre de l’espace disque, ce qui est franchement désavantageux, tandis que la compression des Layer de conteneur remplit déjà le même rôle qu’UPX en réduisant le volume à télécharger lors de la distribution. Certains usages en CLI sont bien plus recommandables : ils permettent d’économiser énormément d’espace disque, le temps de décompression au démarrage est presque imperceptible et musl se prête naturellement aux CLI. Sinon, je serais obligé de pointer du doigt les assistants AUR : ce machin écrit en go n’était pas lié statiquement, si bien qu’un jour yay est tombé en panne sur mon ArchLinux parce qu’il ne trouvait plus une bibliothèque dynamique. Comme il s’agissait lui-même d’un outil d’administration du système, aucune solution directe n’était possible ; j’ai dû démarrer un LiveISO séparé, puis utiliser chroot pour sauver le système.
Résumé
Enfin, même si ces réglages pratiques permettent de distinguer rapidement les profils de développement et de publication, avec un intérêt qui ne fera que devenir plus évident à mesure que le code du projet s’étoffe, je recommande tout de même d’ajouter une tâche d’intégration continue exécutant une compilation LLVM avec la version stable de Rust, de préférence accompagnée de tous vos tests. Ainsi, vous n’aurez plus à changer localement de version nocturne de Rust, les cas limites ne vous prendront pas au dépourvu et l’intégration continue bloquera tout problème dès l’envoi des modifications ; c’est actuellement le mode de travail offrant l’expérience de développement la plus confortable. Voilà pour cette fois-ci ; je recommencerai à bricoler dessus quand j’aurai le temps.