Me gusta Rust desde hace mucho tiempo. Sus virtudes son evidentes, pero sus defectos también. Ofrece seguridad de memoria sin recolección de basura, abstracciones sin coste adicional, concurrencia segura, probablemente la mejor cadena de herramientas y el mejor ecosistema de apoyo disponibles hoy en día, un ámbito de aplicación extraordinariamente amplio —desde servidores web en la nube hasta microcontroladores— y un excelente diseño para el manejo de errores. ¿Y sus defectos? ¿Una curva de aprendizaje pronunciada? ¿La dificultad de entender las restricciones de modelos como la propiedad y el préstamo? ¿La lentitud al escribir código?
Durante mucho tiempo, todos consideramos que estos eran defectos de Rust. Sin embargo, los dos primeros pueden superarse ejercitando nuestra forma de pensar y comprender, mientras que la lentitud de la compilación sigue entorpeciendo mi flujo de trabajo. Hace unos años, todo esto parecía estar bien: antes de que la AI lo arrasara todo, me sobraba paciencia y a menudo me quedaba hasta la madrugada trabajando en un algoritmo o una función. ¿Pero ahora? Difícilmente puedo decir que no he cambiado. Me he vuelto completamente impaciente: no quiero pensar en absoluto cómo escribir código Rust, no soporto esperar la interminable barra de progreso de Cargo y, sobre todo, la fase de ld ni siquiera muestra avance alguno; cada vez se queda ahí, aparentemente bloqueada. Es realmente frustrante.
¿De verdad no hay ninguna solución para todo esto? En realidad, sí la hay. Hace aproximadamente un mes probé varias formas de acelerar mi proceso de desarrollo en Rust, entre ellas algunas optimizaciones del flujo de trabajo, pero casi todo el tiempo de espera seguía concentrándose en Cargo. Si no se resuelve este problema, lo demás solo aliviará los síntomas sin abordar la causa. Así que aprovecharé la ocasión para hablar brevemente sobre cómo optimizar la configuración de Cargo.toml durante el desarrollo en Rust y sobre los ajustes complementarios necesarios.
Teoría del backend
En el diseño de Rust, LLVM es algo perezoso, pero la elección es muy acertada. A diferencia de Go, que mantiene por sí mismo todo el proceso de conversión a código máquina, Rust delega en el gran ecosistema de LLVM las optimizaciones maduras, lo que resulta realmente beneficioso. El flujo completo de compilación de Rust se puede describir aproximadamente de la siguiente manera: el código fuente primero pasa por análisis léxico y sintáctico, generando un árbol de sintaxis abstracta (AST); después se realiza la expansión de macros y el “lowering” del HIR (aplanamiento). A continuación se lleva a cabo la comprobación de tipos habitual y una pequeña verificación de préstamos, y finalmente se genera la representación intermedia (MIR). Hasta aquí, todo el trabajo lo realiza el front‑end propio del compilador de Rust.
Lo que sigue después del MIR se delega a LLVM, por ejemplo, traduce el MIR a LLVM IR, luego LLVM ejecuta su conjunto de pases de optimización (de O0 a O3). Finalmente genera el código máquina para la plataforma objetivo y lo pasa al enlazador para que lo combine en un archivo ejecutable BIN.
Entonces, ¿dónde está exactamente el problema? En realidad, la respuesta es muy sencilla: LLVM es una infraestructura muy pesada, y ese peso es apropiado en entornos de producción. Sacrificar tiempo de compilación para reducir el tiempo de ejecución es una filosofía muy acertada. LLVM sirve de puente para numerosos lenguajes de alto nivel, como Rust, C, C++ y Swift. Esto significa que su cadena de optimización está diseñada para «generar el mejor código máquina posible», no para «terminar la compilación rápidamente». Ejecutar sus decenas de pasadas de optimización en modo release consume muchísimo tiempo. Incluso con O0 en modo debug, LLVM tiene que recorrer todo el proceso de generación de la representación intermedia y del código máquina, un proceso que ya de por sí no es ligero. Además, la monomorfización de genéricos de Rust expande una gran cantidad de código durante la compilación, de modo que la representación intermedia entregada a LLVM es mucho más voluminosa de lo que sugiere el código fuente, y la carga de trabajo que LLVM debe procesar aumenta naturalmente en la misma medida.
Cranelift
Así que, en el fondo, buena parte del tiempo de compilación lento no se va en el frontend de Rust, sino en LLVM, ese «backend pesado». Y ahí surge la pregunta: ¿se podría prescindir de él? Existe un backend llamado Cranelift hecho justo para esa necesidad. Empezó como Cretonne, lanzado en 2016 y desarrollado por la Bytecode Alliance, como un backend de generación de código pensado en origen Wasmtime; más tarde el proyecto Rust lo adoptó como backend de codegen opcional.


Entonces, ¿dónde se supone exactamente que debe ser más rápido Cranelift? Su mejor momento es la fase de desarrollo. En esa etapa quizá no necesites en absoluto un código máquina casi perfecto, optimizado al límite de la eficiencia de ejecución; tal vez solo necesitemos obtener una respuesta rápida. Basta con que ese código máquina no tan bueno sea semánticamente equivalente al código máquina generado correctamente por LLVM. Las primeras versiones de Cranelift no podían garantizarlo debido a numerosos casos límite. Aunque todavía existen, la situación ha mejorado mucho: hoy, la probabilidad de que Cranelift funcione mientras LLVM falla es aproximadamente la misma que la de provocar un error interno de rustc al escribir Rust. Para generar código máquina optimizado al extremo, LLVM ejecuta decenas de pasadas de optimización, como el desenrollado de bucles, la vectorización, la propagación de constantes y la eliminación de código muerto… además de muchas otras, puliendo el código capa por capa. Cranelift, en cambio, sigue una filosofía de diseño completamente distinta: reduce drásticamente esos pasos de optimización, realiza únicamente la asignación básica de registros y la selección de instrucciones, y completa la generación de código con un único barrido lineal, sin iteraciones repetidas. Su representación intermedia también es más ligera y está diseñada específicamente para traducir con rapidez una representación intermedia de alto nivel a código máquina, a diferencia de LLVM IR, que arrastra décadas de lastre derivado de su propósito general.
Hasta aquí las ventajas -- ¿y el precio? Lo evidente primero: el código que genera Cranelift se ejecuta más lento que el de LLVM, entre un 10%~30% más lento según el caso. Pero en cuanto uno se relaja, descubre que esto no importa nada en la fase de desarrollo. ¿Para qué quiero yo esa velocidad? ¿Estoy haciendo un benchmark, o una build release en CI? Yo lo que quiero, , es que cargo build termine antes, para ver si la lógica sale. Y te apuesto lo que quieras a que la mayoría de los programas que escribes no pueden saturar los recursos de cómputo más del 80% del tiempo -- tendría que entrar trabajo de verdad, ¿y cuánto trabajo hay mientras desarrollas? Tu CPU seguramente está todo el rato, mientras que soy yo quien necesita ver el resultado y verificar la lógica. Entonces ese cambio de tiempo de compilación por eficiencia en ejecución, ¿no habría que echar la cuenta al revés dentro del bucle de desarrollo?
Unidades de generación de código
Hablemos también de codegen-units. Este parámetro controla en cuántas unidades mínimas divide el compilador una crate para que el backend las procese en paralelo. De forma predeterminada, se usan 256 unidades en modo de depuración y 16 en modo de publicación. Cuanto mayor sea el número, mayor será el paralelismo y más rápida la compilación, ya que varios núcleos de la CPU pueden ejecutar simultáneamente la generación de código del backend. El coste es una optimización menos eficaz: como cada unidad se optimiza por separado, LLVM (o Cranelift) dispone de menos contexto, por lo que hay menos oportunidades de inserción en línea y optimización entre unidades.
Sin embargo, en una compilación real de producción, por lo general conviene usar el otro extremo, codegen-units = 1. Solo así se puede optimizar al máximo el resultado generado. Al fin y al cabo, si ya usas Rust, ¿no es de lo más natural cambiar tiempo de compilación por rendimiento en tiempo de ejecución?
Nivel de optimización
Otro ajuste configurable que suele pasarse por alto es opt-level. Su valor predeterminado debería ser "3", pero en las compilaciones de producción es más habitual establecerlo en "z". Así se reduce gratis el tamaño del artefacto sin modificar el código, por lo que no hay motivo para no hacerlo. Sin embargo, en el modo de desarrollo debería establecerse en "0", ya que desactivar por completo la optimización permite compilar lo más rápido posible.
Otro pequeño truco es que Cargo.toml permite establecer distintos niveles de optimización para las dependencias y el código propio:
[profile.dev.package."*"]
opt-level = 3
Así se pueden compilar las dependencias de terceros con O3, lo que solo aumenta el tiempo de la primera compilación limpia; las posteriores serán incrementales. Las dependencias externas no suelen actualizarse con frecuencia, por lo que usar O3 para ellas y O0 para el código de la propia aplicación suele ofrecer una buena experiencia en modo de desarrollo, con un equilibrio adecuado entre velocidad y tamaño del binario. Sin embargo, para el modo de publicación sigo recomendando llevar la optimización al máximo con O3 o Z; no hay mucho más que decir.
Optimización en el enlazado
La LTO (optimización en tiempo de enlace) es otra función que consume muchísima memoria y tiempo de compilación, aunque se recomienda activarla en las compilaciones de lanzamiento de la mayoría de los proyectos. Durante una compilación normal, cada crate se optimiza por separado, por lo que el backend del compilador no puede ver las relaciones de llamadas entre crates ni realizar ciertas inserciones en línea y eliminaciones de código muerto entre crates, pese a que estos casos son muy frecuentes. La LTO elimina esta barrera y proporciona al optimizador la representación intermedia de todas las crates durante el enlace para que realice una pasada de optimización global. Sin embargo, nunca añadas lto = true directamente a un perfil sin pensarlo, pues la compilación de Rust se volverá desesperadamente lenta; revisa bien la configuración y actívala únicamente al usar el perfil de lanzamiento.
Eliminar los símbolos de depuración
Como ocurre con todo lo demás, la información de depuración y los símbolos de Rust se almacenan aquí. Activar strip en el modo de publicación puede reducir muchísimo el tamaño (normalmente, 50 MB frente a 5 MB), una diferencia sencillamente descomunal. Eliminar los símbolos también es más seguro, pues la mayoría de las filtraciones del código fuente de la interfaz ocurren al publicar por accidente los mapas de código fuente en npm :(
Así que no hay mucho que decir sobre el perfil de desarrollo: no puedes eliminar la información de depuración, pues entonces no podrías depurar con normalidad mediante gdb / lldb ni ver nombres de funciones significativos en la traza de llamadas. Sin embargo, ten en cuenta que Arch Linux la elimina de forma predeterminada al crear paquetes. Esto genera un pequeño conflicto: como ya la hemos eliminado, puede producirse un error más adelante. Al crear un paquete de AUR, conviene omitir explícitamente este paso.
¡Abandona los pánicos!
En el código de negocio normal, panic no debería existir. Cuando el código de negocio habitual encuentra un error durante la ejecución, cualquier Err para el que se haya diseñado tolerancia a fallos debería devolverse de forma segura, en lugar de provocar un pánico de manera abrupta. Al igual que React ErrorBoundary, debería tratarse normalmente como un error. Solo debería desencadenarse un pánico cuando el código esté convencido de haber entrado en un estado imposible e irrecuperable. Mi filosofía personal es renunciar a los pánicos. ¿Por qué? Porque, en la práctica, las pruebas del código de negocio pueden dividirse en tres capas: primero la ruta correcta, después una ruta de error —una entre infinitas posibilidades— y, solo en tercer lugar, los casos límite descubiertos exhaustivamente mediante pruebas con entradas aleatorias o de colisión. Desde el punto de vista de la ingeniería, la ruta correcta puede probarse al 100 %; para las rutas de error, puede elegirse una de las n variantes de cada categoría. Las pruebas de colisión son una mera cuestión de tiempo y casi nunca merecen la pena. Cuando el volumen de usuarios crezca de verdad, sabrás por ti mismo cuándo necesitas hacerlas; por lo general, yo nunca las hago.
Por tanto, un buen código debe incluir pruebas que cubran una clase de rutas exitosas y al menos una ruta de error. En esa clase de rutas de error basta con cubrir un solo caso para comprobar que el error se devuelve como Err; así se puede escribir una lógica de respaldo y, de forma natural, enumerarlo con thiserror o interceptarlo con anyhow, aplanarlo, imprimirlo y registrarlo. En resumen, el propio código te obliga a crear mecanismos para manejar estas situaciones. Una vez alcanzado este nivel, panic deja de servirte: puedes entenderlo como «teóricamente imposible», pero solo en teoría. En el mundo real aún existen errores del sistema operativo, errores de memoria, inversiones de bits provocadas por electrones de rayos cósmicos, desbordamientos extraños… Nunca podrás cubrir todas estas situaciones. Entonces, ¿por qué evitar provocar un pánico? Porque es muy probable —con una probabilidad del 90 %— que estas situaciones no sean problemas de tu código. La esencia de panic es que, cuando ocurre, Rust retrocede nivel por nivel por la pila de llamadas e invoca el destructor (drop) de cada marco para liberar los recursos. Este proceso exige que el compilador genere una tabla unwind adicional destinada a localizar errores en la lógica de negocio. Si lo más probable es que el error no proceda de tu código, ¿qué valor tiene esa información? Mantenerla también aumenta el tamaño del artefacto compilado y el trabajo del enlazador, por lo que desactivarla es la decisión correcta. Si tu código está bien probado y tienes suficiente confianza en él, recomiendo configurar panic = abort.
Pruebas prácticas
Basta de hablar: veamos las mejoras reales que aportan estas combinaciones tomando como referencia un pequeño proyecto experimental que hice hace unos meses.
La parte de Rust de este proyecto contiene aproximadamente 32 000 líneas de código fuente, sin contar las dependencias.
Rendering is a protocol, not a render-time computation.
Este repositorio es en realidad un monorrepositorio con muchos subproyectos, pero en él destacan dos ejemplos representativos. Las características del paquete Skeleton resultan evidentes a primera vista: contiene mucho código y tiene muy pocas dependencias. Será el paquete con la mayor proporción de generación de código de todo el proyecto, por lo que resulta especialmente adecuado para aprovechar las capacidades de Cranelift. Además, es un paquete muy limpio; aquí, «limpio» significa que está escrito íntegramente en Rust seguro.
En cambio, el siguiente paquete de interfaz de línea de comandos no resulta demasiado adecuado. Que tenga muchas dependencias no es realmente un problema y, en teoría, incluso debería permitir apreciar mejor la eficiencia, pero aquí aparece una disyuntiva clásica: en la esquina superior izquierda se puede ver que la dependencia ring está marcada como opcional. Esto se debe a que el proyecto utilizaba originalmente aws-lc-rs; ambas son implementaciones de respaldo de algoritmos criptográficos para Rust. Pero ¿por qué hacerla opcional? Porque ring está escrita íntegramente en Rust, mientras que la otra es una implementación en ensamblador incorporada mediante una interfaz de funciones foráneas y optimizada específicamente para arquitecturas de procesador comunes como x86 y arm64. Sin embargo, ahí reside también su desventaja: la magia de Cranelift se limita al Rust puro. En cuanto se introduce código no seguro, C o ensamblador mediante una interfaz de funciones foráneas, o algo similar, la compatibilidad de Cranelift pasa a ser extremadamente deficiente.
Sin embargo, este problema sí tiene solución: se puede seleccionar el backend con cfg y compilar con ring en el modo Cranelift. Tras configurar los perfiles de desarrollo y producción como se describió anteriormente, basta con comparar la compilación de la interfaz de línea de comandos para comprobar que, en estas condiciones, la compilación de desarrollo es al menos tres veces más rápida que la de producción, incluso tratándose de compilaciones en frío sin procesamiento incremental. Con el nivel de optimización O0 y la optimización en tiempo de enlace desactivada, el perfil de desarrollo debería ser decenas de veces más rápido que el de producción durante las actualizaciones incrementales posteriores. Esto se debe a que técnicas como la optimización en tiempo de enlace funcionan aplanando los límites entre los distintos paquetes; una vez que todo se convierte en una sola unidad, modificar una parte del código obliga a recompilarla por completo e impide realizar correctamente las actualizaciones incrementales.


En conjunto, los resultados muestran que en realidad no hay demasiada diferencia entre ambos. No supone un salto cualitativo, pero la diferencia sí se percibe claramente. La razón principal es la enorme potencia de Apple Silicon: los chips de la serie M tienen un rendimiento mononúcleo y un ancho de banda de memoria descomunales, ventajas que aprovechan especialmente bien las tareas de compilación, intensivas tanto en cálculo como en E/S. Por lo general, la diferencia sería aún mayor al ejecutarlos en Linux; pero si se instalara algo como Asahi Linux en un MacBook, Linux ganaría sin lugar a dudas.
El enlazador obsoleto
En Linux, Rust usa GNU ld (bfd) de forma predeterminada; sí, precisamente el enlazador más antiguo y lento. Funciona con un solo hilo y realiza tanto la resolución de símbolos como las reubicaciones mediante recorridos secuenciales, por lo que empieza a lastrar claramente el proceso cuando el proyecto crece. En Linux puedes probar mold, creado por @Rui Ueyama; configurarlo es tan sencillo como añadir una línea a .cargo/config.toml.
[target.x86_64-unknown-linux-gnu]
linker = "clang"
rustflags = ["-C", "link-arg=-fuse-ld=mold"]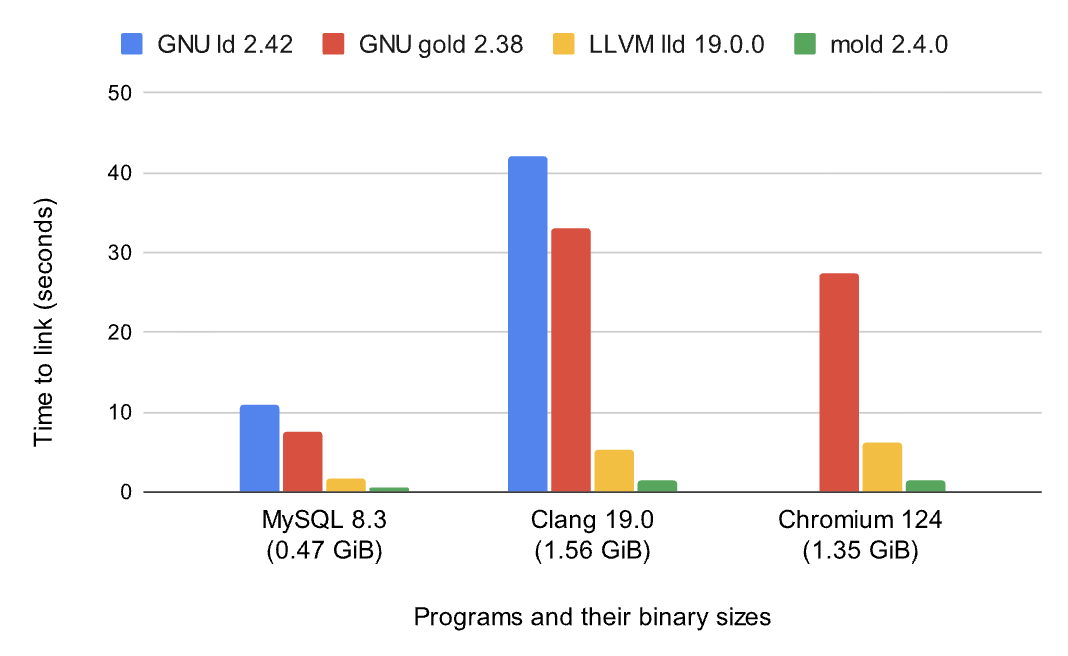
La mejora es bastante evidente, pero por desgracia en macOS solo está sold, un proyecto comercial. La buena noticia es que lld en macOS y ld64, incluido por Apple, ya son bastante rápidos, especialmente el nuevo enlazador introducido con Xcode 15, cuya mejora de velocidad es espectacular. Su único inconveniente es que los sistemas de integración continua desatendidos con macOS tienen que aceptar un acuerdo mediante sudo después de cada actualización, lo que ha provocado que mis tareas programadas de integración continua fallen varias veces.
MUSL frente a glibc
Yo mismo soy un y odio profundamente GNU glibc, pero para desarrollar te sigo recomendando x86_64-unknown-linux-gnu. ¿Por qué? Porque es rápido. El mayor punto fuerte de MUSL es que puede generar binarios enlazados de forma completamente estática: no dependen de ninguna biblioteca dinámica del sistema, así que copias lo compilado a cualquier máquina Linux y funciona, algo especialmente adecuado para contenedores y sistemas embebidos. Pero la lentitud también viene de ese enlazado estático: el enlazador tiene que empaquetarlo todo, y la fase de enlazado supone bastante más trabajo que el enlazado dinámico.
Sin embargo, la buena noticia es que, si usas macOS, no tienes que preocuparte en absoluto: aarch64-apple-darwin es actualmente la única opción. Por diseño, macOS no admite el enlazado totalmente estático, lo que en realidad resulta beneficioso desde el punto de vista de la velocidad de compilación. Por tanto, el perfil de desarrollo usa GNU libc en Linux y libSystem en macOS, mientras que el perfil de publicación puede usar musl tanto en macOS como en Linux. Debido a las herramientas de enlace y archivado que macOS elige de forma predeterminada, lo único que debes tener en cuenta es que quizá tengas que configurar .cargo/config.toml.
[target.x86_64-unknown-linux-musl]
linker = "x86_64-linux-musl-gcc"
ar = "x86_64-linux-musl-ar"
Por cierto, no uses Zig bajo ningún concepto: zbuild presenta actualmente problemas graves en Rust Nightly. Cuando necesites compilación cruzada y el equipo anfitrión sea Linux x86, recomiendo cross junto con Docker; funciona muy bien y trae todos los entornos necesarios. También es una opción excelente si prefieres glibc. Como glibc solo garantiza la retrocompatibilidad, la práctica habitual consiste en compilar con la versión de glibc incluida en una edición de Debian dos versiones principales anterior; de lo contrario, una glibc demasiado reciente impedirá que el programa funcione en muchísimas máquinas. No se debe a que hayas usado alguna función nueva: simplemente comprueba la versión indicada en una cadena de caracteres para fastidiarte. Si el equipo anfitrión es un Mac, usa el target + cargo build --release nativo de rustup
UPX es algo malo
Otro punto que merece la pena comentar es el uso de UPX; sé que he dicho que me gusta musl, pero aspirar al mismo tiempo a un binario pequeño es, en realidad, bastante contradictorio y no parece tener mucho sentido...
                 ooooo     ooo  ooooooooo.  ooooooo  ooooo
                 `888'     `8'  `888   `Y88. `8888    d8'
                  888       8    888   .d88'   Y888..8P
                  888       8    888ooo88P'     `8888'
                  888       8    888           .8PY888.
                  `88.    .8'    888          d8'  `888b
                    `YbodP'     o888o       o888o  o88888o


                    The Ultimate Packer for eXecutables
   Copyright (c) 1996-2026 Markus Oberhumer, Laszlo Molnar & John Reiser
                           https://upx.github.io
Sin embargo, en la práctica UPX resuelve este problema. Su funcionamiento consiste en comprimir el binario y envolverlo con un módulo de descompresión; al ejecutarlo, primero se descomprime en memoria y después se pone en marcha. Esto permite reducir su tamaño a aproximadamente un 30–50 % del original, lo que supone una ventaja considerable. Pero precisamente por ese motivo, combinar UPX con el enlazado dinámico de GNU glibc puede causar graves problemas: los binarios enlazados dinámicamente con glibc contienen secciones especiales y mecanismos de carga dinámica cuyas estructuras pueden quedar dañadas tras la compresión con UPX, haciendo que las bibliotecas dinámicas no se encuentren durante la ejecución segment fault. Musl, en cambio, resulta especialmente adecuado para UPX: sus binarios ya están enlazados de forma completamente estática y su estructura interna es estable, por lo que UPX puede comprimirlos y descomprimirlos limpiamente. Por tanto, añadir un paso de UPX a la integración continua de las versiones de musl aporta un valor considerable.
Tampoco se debe abusar de UPX, pues solo resulta apropiado para tareas de larga duración o poco frecuentes. Las tareas largas encajan bien porque, al iniciarse, UPX necesita descomprimir una vez el programa en la memoria; aunque este proceso es totalmente automático y solo añade un pequeño retraso al arranque en frío, puede seguir siendo fatal en rutas de ejecución muy frecuentes. Por eso es ideal para una tarea que se inicia una vez y luego permanece ejecutándose en segundo plano. Sin embargo, no recomiendo aplicar UPX indiscriminadamente a los paquetes de servicios de larga duración incluidos en imágenes docker, ya que en la práctica se intercambia memoria por espacio en disco, un trato pésimo, y la compresión de los Layer del contenedor ya cumple la misma función que UPX al reducir el tamaño de la descarga durante la distribución. Es mucho más recomendable para ciertos usos de CLI: ahorra muchísimo espacio en disco, el tiempo de descompresión al arrancar es casi imperceptible y musl también se adapta de forma natural a las CLI. De lo contrario, tendría que señalar expresamente a los asistentes de AUR: aquel trasto escrito en go no estaba enlazado estáticamente, así que una vez yay dejó de funcionar en mi ArchLinux porque no encontraba una biblioteca dinámica. Como además era una herramienta de administración del propio sistema, no había una solución directa; tuve que arrancar otro LiveISO y finalmente entrar mediante chroot para rescatar el sistema.
Resumen
Por último, aunque estas prácticas configuraciones permiten distinguir rápidamente los perfiles de desarrollo y publicación, y su utilidad se vuelve cada vez más evidente a medida que crece el código del proyecto, sigo recomendando añadir una tarea de integración continua que ejecute una compilación LLVM con la versión estable de Rust, preferiblemente junto con todas tus pruebas. Así no tendrás que cambiar la versión nocturna de Rust en tu entorno local, los casos límite no te tomarán por sorpresa y la integración continua detendrá cualquier problema en cuanto envíes los cambios; actualmente, esta es la forma de trabajo que ofrece la experiencia de desarrollo más cómoda. Eso es todo por esta vez; volveré a trastear con ello cuando tenga tiempo.