Ich mag Rust schon seit Langem. Seine Stärken liegen klar auf der Hand, aber seine Schwächen ebenso. Speichersicherheit ohne automatische Speicherbereinigung, Abstraktionen ohne Zusatzkosten, sichere Nebenläufigkeit, die derzeit wohl beste Werkzeugkette samt Ökosystem, ein enorm breites Einsatzgebiet – von Webservern in der Cloud bis hin zu Mikrocontrollern – und ein ausgesprochen gutes Konzept zur Fehlerbehandlung. Die Nachteile? Eine steile Lernkurve? Schwer verständliche Modellvorgaben wie Eigentümerschaft und Ausleihe? Langsames Programmieren?
Lange Zeit hielten wir all das für Nachteile von Rust. Tatsächlich lassen sich die ersten beiden jedoch durch das Schulen der eigenen Denk- und Wahrnehmungsweise überwinden; die langsame Kompilierung dagegen bremst meinen Arbeitsablauf bis heute aus. Vor einigen Jahren schien das noch in Ordnung zu sein: Bevor AI alles überrollte, hatte ich vor allem Geduld und arbeitete für einen Algorithmus oder eine Funktion oft bis tief in die Nacht. Aber heute? Ich kann kaum behaupten, dass ich mich nicht verändert hätte. Ich bin völlig ungeduldig geworden, möchte überhaupt nicht mehr darüber nachdenken, wie man Rust-Code schreibt, und kann den endlosen Fortschrittsbalken von Cargo nicht mehr abwarten. Besonders schlimm ist die ld-Phase, in der nicht einmal ein Fortschritt angezeigt wird und alles jedes Mal einfach hängen bleibt. Das ist wirklich frustrierend.
Gibt es denn wirklich keine Lösung für all das? Doch, die gibt es. Vor etwa einem Monat habe ich verschiedene Möglichkeiten ausprobiert, meinen Rust-Entwicklungsprozess zu beschleunigen, darunter auch Optimierungen am Arbeitsablauf. Tatsächlich entfiel die Wartezeit aber fast immer auf Cargo. Solange dieses Problem nicht gelöst ist, bekämpft alles andere nur die Symptome. Daher möchte ich die Gelegenheit nutzen, kurz auf die Optimierung der Cargo.toml-Konfiguration bei der Rust-Entwicklung und die dazugehörigen ergänzenden Einstellungen einzugehen.
Backend-Theorie
Im Design von Rust ist LLVM zwar etwas nachlässig, aber die Wahl ist zudem sehr gut. Im Gegensatz zu Go, das den gesamten Prozess der Umwandlung in Maschinencode selbst verwaltet, lässt Rust die große LLVM‑Ökosystem die ausgereiften Optimierungen übernehmen – das ist tatsächlich vorteilhaft. Der gesamte Rust‑Kompilierungsprozess lässt sich grob folgendermaßen beschreiben: Der Quellcode durchläuft zuerst die lexikalische Analyse und die syntaktische Analyse, wodurch ein abstrakter Syntaxbaum (AST) entsteht. Anschließend erfolgen die Makroexpansion und das Herabstufen (Flattening) des High‑Level‑Intermediate‑Representation (HIR). Danach folgen die reguläre Typprüfung und ein wenig Borrow‑Checking, schließlich wird die Mid‑Level‑Intermediate‑Representation (MIR) erzeugt. Bis zu diesem Punkt wird alles vom Frontend des Rust‑Compilers erledigt.
Nach dem MIR wird die weitere Verarbeitung LLVM überlassen: MIR wird in LLVM‑IR übersetzt, danach führt LLVM eine Reihe von Optimierungspässen (von O0 bis O3) aus, erzeugt schließlich den Maschinencode für die Zielplattform und übergibt ihn dem Linker, der daraus eine ausführbare BIN-Datei erstellt.
Wo genau liegt also das Problem? Die Antwort ist eigentlich ganz einfach: LLVM ist eine sehr schwergewichtige Infrastruktur, und für den Produktivbetrieb ist dieses Gewicht durchaus angemessen. Kompilierzeit gegen kürzere Ausführungszeit einzutauschen, ist eine gute Philosophie. LLVM bildet die Brücke zu zahlreichen darüberliegenden Sprachen wie Rust, C, C++ und Swift. Das bedeutet, dass seine Optimierungspipeline darauf ausgelegt ist, „optimalen Maschinencode zu erzeugen“, und nicht darauf, „die Kompilierung schnell abzuschließen“. Die Dutzenden Optimierungsdurchläufe einmal im release-Modus auszuführen, kostet sehr viel Zeit. Selbst bei O0 im debug-Modus muss LLVM weiterhin den gesamten Ablauf von der Erzeugung der Zwischendarstellung bis zur Erzeugung des Maschinencodes durchlaufen, und schon dieser Ablauf ist keineswegs leichtgewichtig. Hinzu kommt, dass Rusts Monomorphisierung generischer Typen während der Kompilierung große Mengen an Code entfaltet. Dadurch ist die an LLVM übergebene Zwischendarstellung erheblich umfangreicher, als der Quellcode vermuten lässt, und entsprechend wächst natürlich auch der Arbeitsaufwand für LLVM.
Cranelift
Im Kern steckt die lange Kompilierzeit also größtenteils nicht im Rust-Frontend selbst, sondern in LLVM, diesem "schweren Backend". Damit stellt sich die Frage: Kann man es nicht einfach weglassen? — es gibt ein Backend namens Cranelift, das genau für diesen Bedarf gebaut wurde. Ursprünglich hieß es Cretonne, gestartet 2016, entwickelt von der Bytecode Alliance, und war anfangs — als Codegen-Backend genau dafür entworfen; später nahm Rust es offiziell auf und machte es zum optionalen Codegen-Backend.


Wo genau soll Cranelift also schneller sein? Seine Stärken spielt es am besten während der Entwicklung aus. In dieser Phase braucht man vielleicht gar keinen nahezu perfekten Maschinencode, dessen Ausführungseffizienz bis ans Äußerste optimiert wurde, sondern lediglich schnelles Feedback. Es genügt, wenn dieser nicht ganz so gute Maschinencode semantisch äquivalent zu dem von LLVM sorgfältig erzeugten Maschinencode ist. Frühe Versionen von Cranelift konnten das wegen zahlreicher Randfälle noch nicht gewährleisten. Solche Fälle gibt es zwar weiterhin, doch die Lage hat sich erheblich verbessert: Dass Cranelift funktioniert, während LLVM scheitert, ist heute ungefähr so wahrscheinlich, wie beim Schreiben von Rust einen internen Compilerfehler in rustc auszulösen. Um extrem optimierten Maschinencode zu erzeugen, führt LLVM Dutzende Optimierungsdurchläufe aus, darunter Schleifenentrollung, Vektorisierung, Konstantenfortpflanzung und die Beseitigung toten Codes – und noch sehr viele weitere –, die den Code Schicht für Schicht verfeinern. Cranelift verfolgt hingegen eine völlig andere Designphilosophie: Es reduziert diese Optimierungsschritte drastisch, führt nur eine grundlegende Registerzuweisung und Befehlsauswahl durch und schließt die Codeerzeugung mit einem einzigen linearen Durchlauf ab, ohne wiederholte Iterationen. Auch seine Zwischendarstellung ist schlanker und eigens darauf ausgelegt, eine höherstufige Zwischendarstellung schnell in Maschinencode zu übersetzen, statt wie LLVM IR die Last jahrzehntelanger Verallgemeinerung zu tragen.
So viel zu den Vorteilen -- und der Preis? Offensichtlich zuerst: Der Code, den Cranelift erzeugt, läuft langsamer als der von LLVM, je nach Szenario etwa 10%~30% langsamer. Aber wenn man loslässt, merkt man, dass das in der Entwicklungsphase überhaupt keine Rolle spielt. Wozu brauche ich diese Geschwindigkeit? Fahre ich einen Benchmark, oder einen Release-Build in der CI? Ich will nur, dass cargo build schneller fertig wird, damit ich sehe, ob die Logik aufgeht. Und ich wette, die meisten Programme, die du schreibst, können die Rechenressourcen unmöglich über 80% der Zeit auslasten -- dafür müsste erst einmal echte Last hereinkommen, und wie viel davon gibt es beim Entwickeln? Die CPU vermutlich die ganze Zeit, während ich derjenige bin, der das Ergebnis sehen und die Logik prüfen muss. Diese Rechnung also, Kompilierzeit gegen Laufzeiteffizienz -- sollte sie in der Entwicklungsschleife nicht andersherum aufgemacht werden?
Codegenerierungseinheiten
Kommen wir außerdem zu codegen-units. Dieser Parameter steuert, in wie viele kleinste Einheiten der Compiler eine Crate aufteilt, damit das Backend sie parallel verarbeitet. Standardmäßig sind es im Debug-Modus 256 und im Release-Modus 16 Einheiten. Je höher die Zahl, desto stärker die Parallelisierung und desto schneller die Kompilierung, weil mehrere CPU-Kerne gleichzeitig die Codegenerierung des Backends ausführen können. Dafür fällt die Optimierung schwächer aus: Da jede Einheit separat optimiert wird, steht LLVM (oder Cranelift) weniger Kontext zur Verfügung, sodass es weniger Möglichkeiten zur einheitenübergreifenden Inline-Ersetzung und Optimierung gibt.
Bei einem echten Release-Build sollte man jedoch in der Regel das andere Extrem, codegen-units = 1, verwenden. Nur so lässt sich das Ergebnis maximal optimieren. Wenn man schon Rust verwendet, ist es schließlich nur selbstverständlich, Kompilierzeit gegen Laufzeitleistung einzutauschen, oder?
Optimierungsstufe
Eine weitere häufig übersehene, aber anpassbare Einstellung ist opt-level. Standardmäßig sollte sie auf "3" stehen, bei Release-Builds wird sie jedoch üblicherweise auf "z" gesetzt. Dadurch lässt sich die Größe des Artefakts ohne jede Codeänderung kostenlos reduzieren – warum also nicht? Im Entwicklungsmodus sollte sie hingegen auf "0" stehen, da vollständig deaktivierte Optimierungen die schnellsten Builds ermöglichen.
Ein weiterer kleiner Trick besteht darin, dass sich mit Cargo.toml unterschiedliche Optimierungsstufen für Abhängigkeiten und den eigenen Code festlegen lassen:
[profile.dev.package."*"]
opt-level = 3
So lassen sich Drittanbieterabhängigkeiten mit O3 kompilieren, wodurch sich nur der erste vollständige Build verlängert; alle weiteren Builds erfolgen inkrementell. Externe Abhängigkeiten werden in der Regel nicht häufig aktualisiert. Wenn man für sie O3 und für den eigenen Anwendungscode O0 verwendet, erhält man daher meist eine gute Entwicklungsumgebung mit einem ausgewogenen Verhältnis zwischen Geschwindigkeit und Binärgröße. Im Veröffentlichungsmodus empfehle ich jedoch weiterhin, die Optimierung mit O3 oder Z voll auszureizen – dazu gibt es nicht viel mehr zu sagen.
Linkzeitoptimierung
LTO (Linkzeitoptimierung) ist eine weitere Funktion, die sehr viel Arbeitsspeicher und Kompilierzeit benötigt, deren Aktivierung für Release-Builds jedoch bei den meisten Projekten empfohlen wird. Bei einer normalen Kompilierung wird jede Crate unabhängig optimiert; deshalb kann das Compiler-Backend die Aufrufbeziehungen zwischen Crates nicht erkennen und bestimmte Crate-übergreifende Einbindungen und Bereinigungen ungenutzten Codes nicht durchführen, obwohl solche Fälle sehr häufig auftreten. LTO hebt diese Grenze auf und stellt dem Optimierer beim Linken die Zwischendarstellung aller Crates für einen globalen Optimierungsdurchlauf bereit. Füge einem Profil aber keinesfalls unbedacht direkt lto = true hinzu, denn dadurch wird die Rust-Kompilierung unerträglich langsam; prüfe die Konfiguration sorgfältig und aktiviere es nur für das Release-Profil.
Debugsymbole entfernen
Wie alles andere werden auch die Debug-Informationen und Symbole von Rust hier gespeichert. Wird im Release-Modus strip aktiviert, lässt sich die Größe erheblich reduzieren (normalerweise 50 MB gegenüber 5 MB) – ein geradezu irrsinniger Unterschied. Das Entfernen der Symbole ist außerdem sicherer, denn Frontend-Quellcode gelangt meistens an die Öffentlichkeit, weil Quellzuordnungsdateien versehentlich auf npm veröffentlicht werden :(
Zum Entwicklungsprofil gibt es also nicht viel zu sagen: Die Debuginformationen können schließlich nicht entfernt werden, denn dann wäre ein normales Debugging mit gdb / lldb nicht mehr möglich und auch die Stapelrückverfolgung würde keine aussagekräftigen Funktionsnamen anzeigen. Beachte jedoch, dass Arch Linux sie beim Paketieren standardmäßig entfernt. Das führt hier zu einem kleinen Konflikt: Da wir sie bereits entfernt haben, kann später ein Fehler auftreten. Beim Erstellen eines AUR-Pakets sollte dieser Schritt daher ausdrücklich übersprungen werden.
Schluss mit Panics!
In normalem Anwendungscode sollte panic nicht vorkommen. Wenn gewöhnlicher Anwendungscode zur Laufzeit auf einen Fehler stößt, sollte jeder Err-Wert, für den Fehlertoleranz vorgesehen ist, sicher zurückgegeben werden, statt einen brachialen Panikabbruch auszulösen. Wie bei React ErrorBoundary sollte er ganz normal als Fehler behandelt werden. Eine Panik sollte nur ausgelöst werden, wenn der Code sicher ist, einen unmöglichen und nicht wiederherstellbaren Zustand erreicht zu haben. Meine persönliche Philosophie lautet, auf Panikabbrüche zu verzichten. Warum? Weil sich Anwendungscode in der Praxis in drei Schichten testen lässt: zuerst der erfolgreiche Pfad, dann ein Fehlerpfad – eine von unendlich vielen Möglichkeiten – und erst danach die Grenzfälle, die durch Fuzz- oder Kollisionstests erschöpfend gefunden werden. Aus technischer Sicht kann der erfolgreiche Pfad zu 100 % getestet werden; bei Fehlerpfaden lässt sich aus den n Varianten einer Kategorie eine auswählen. Kollisionstests sind lediglich eine Frage der Zeit und lohnen sich meistens nicht. Sobald die Zahl der Nutzer wirklich groß genug ist, erkennt man selbst, wann sie nötig werden; grundsätzlich führe ich sie nie durch.
Guter Code sollte daher Tests enthalten, die eine Klasse von Erfolgspfaden und mindestens einen Fehlerpfad abdecken. Bei dieser Klasse von Fehlerpfaden genügt ein einziger Fall, um zu prüfen, ob der Fehler als Err zurückgegeben wird. So lässt sich eine Rückfalllogik schreiben und der Fall ganz selbstverständlich mit thiserror aufzählen oder mit anyhow abfangen, abflachen, ausgeben und protokollieren. Kurz gesagt zwingt dich dein Code dazu, Mechanismen für den Umgang mit solchen Situationen zu entwickeln. Hast du diese Stufe erreicht, ist panic für dich nutzlos: Du kannst es als „theoretisch unmöglich“ betrachten, doch eben nur theoretisch. In der wirklichen Welt gibt es weiterhin Betriebssystemfehler, Speicherfehler, durch einzelne Elektronen kosmischer Strahlung verursachte Bit-Kippfehler, merkwürdige Überläufe und mehr. All diese Situationen wirst du niemals vollständig abdecken können. Warum sollte man also keine Panik auslösen? Weil solche Situationen mit hoher Wahrscheinlichkeit – zu 90 Prozent – gar nicht durch deinen Code verursacht werden. Das Wesentliche an panic ist, dass Rust beim Auftreten den Aufrufstapel Ebene für Ebene zurückverfolgt und in jedem Rahmen den Destruktor (drop) aufruft, um Ressourcen freizugeben. Dafür muss der Compiler eine zusätzliche unwind-Tabelle erzeugen, mit der sich Fehler in deiner Geschäftslogik finden lassen. Wenn der Fehler wahrscheinlich gar nicht aus deinem Code stammt, welchen Wert haben diese Informationen dann? Außerdem vergrößert die Tabelle das Kompilat und verursacht zusätzliche Arbeit für den Linker; sie zu deaktivieren ist daher die richtige Entscheidung. Wenn dein Code gründlich getestet ist und du genügend Vertrauen in ihn hast, empfiehlt sich die Konfiguration panic = abort.
Praxistest
Genug geredet – sehen wir uns anhand eines kleinen Spielprojekts, das ich vor einigen Monaten erstellt habe, die tatsächlichen Verbesserungen dieser Kombinationen an.
Der Rust-Teil dieses Projekts umfasst ohne Abhängigkeiten ungefähr 32.000 Quellcodezeilen.
Rendering is a protocol, not a render-time computation.
Dieses Repository ist eigentlich ein Monorepo mit vielen Unterprojekten, doch darin lassen sich zwei typische Beispiele finden. Beim Skeleton-Paket fallen die Merkmale sofort auf: viel Code und äußerst wenige Abhängigkeiten. In diesem Paket wird die Codegenerierung den höchsten Anteil im gesamten Projekt ausmachen, weshalb es sich besonders gut für Cranelift eignet. Außerdem ist das Paket sehr sauber – „sauber“ bedeutet hier, dass es vollständig in sicherem Rust geschrieben ist.
Das folgende CLI-Paket eignet sich dagegen nicht besonders gut. Die vielen Abhängigkeiten sind an sich kein Problem und sollten die Effizienz theoretisch sogar deutlicher zeigen, doch hier gibt es eine klassische Entweder-oder-Entscheidung: Oben links ist die Abhängigkeit ring als optional gekennzeichnet. Das liegt daran, dass das Projekt ursprünglich aws-lc-rs verwendete; beide sind Backends für kryptografische Algorithmen in Rust. Warum ist sie aber optional? Weil ring vollständig in Rust geschrieben ist, während die andere Implementierung über eine Fremdfunktionsschnittstelle eingebundenen Assemblercode nutzt, der eigens für verbreitete Prozessorarchitekturen wie x86 und arm64 optimiert wurde. Genau darin liegt jedoch auch ihr Nachteil: Cranelifts Magie ist auf reines Rust beschränkt. Sobald unsicherer Code, C oder Assembler über eine Fremdfunktionsschnittstelle oder Ähnliches ins Spiel kommt, ist Cranelifts Kompatibilität in der Praxis äußerst schlecht.
Dieses Problem ist jedoch durchaus lösbar: Das Backend lässt sich mit cfg auswählen, und im Cranelift-Modus genügt es, mit ring zu kompilieren. Nachdem die Entwicklungs- und Veröffentlichungsprofile wie oben beschrieben konfiguriert wurden, zeigt ein einfacher Vergleich der CLI-Kompilierung, dass Entwicklungs-Builds unter diesen Bedingungen mindestens dreimal so schnell wie Veröffentlichungs-Builds sind – selbst bei vollständigen Kompilierungen ohne inkrementelle Verarbeitung. Mit O0 und deaktivierter Linkzeitoptimierung sollte das Entwicklungsprofil bei späteren inkrementellen Aktualisierungen sogar um ein Vielfaches von zehn schneller als das Veröffentlichungsprofil sein. Techniken wie die Linkzeitoptimierung beruhen nämlich darauf, die Grenzen zwischen den einzelnen Paketen einzuebnen. Sobald alles zu einer Einheit verschmolzen ist, erzwingt jede Codeänderung eine erneute Kompilierung der gesamten Einheit, sodass korrekte inkrementelle Aktualisierungen nicht mehr möglich sind.


Insgesamt betrachtet unterscheiden sich die beiden eigentlich kaum. Von einem qualitativen Sprung kann keine Rede sein, der Unterschied ist aber definitiv deutlich spürbar. Der Hauptgrund ist, dass Apple Silicon ausgesprochen leistungsfähig ist: Die M-Chips bieten eine geradezu absurd hohe Single-Core-Leistung und Speicherbandbreite, wovon das sowohl rechen- als auch I/O-intensive Kompilieren besonders profitiert. Unter Linux wäre der Abstand normalerweise noch größer; installiert man jedoch etwa Asahi Linux auf einem MacBook, gewinnt Linux eindeutig.
Der veraltete Linker
Unter Linux verwendet Rust standardmäßig GNU ld (bfd) – ja, genau den ältesten und langsamsten Linker. Er arbeitet mit nur einem Thread, und sowohl die Symbolauflösung als auch die Relokation erfolgen durch sequenzielle Durchläufe, sodass er bei größeren Projekten deutlich zum Flaschenhals wird. Unter Linux kann man den von @Rui Ueyama entwickelten Linker mold ausprobieren; die Konfiguration ist denkbar einfach: Man muss lediglich eine Zeile in .cargo/config.toml einfügen.
[target.x86_64-unknown-linux-gnu]
linker = "clang"
rustflags = ["-C", "link-arg=-fuse-ld=mold"]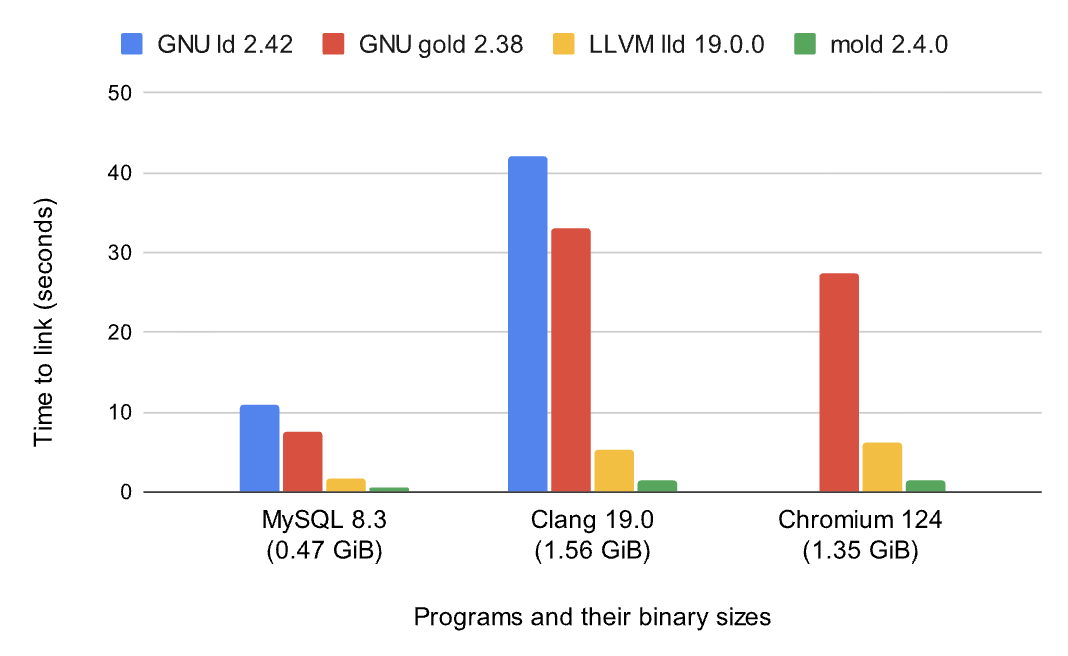
Die Verbesserung ist deutlich spürbar, doch leider gibt es unter macOS nur das kommerzielle Projekt sold. Erfreulicherweise sind lld unter macOS und Apples mitgeliefertes ld64 ohnehin schon recht schnell, insbesondere der mit Xcode 15 eingeführte neue Linker, dessen Geschwindigkeitszuwachs enorm ist. Sein einziger Nachteil besteht darin, dass auf unbeaufsichtigten macOS-CI-Systemen nach jedem Update per sudo einer Vereinbarung zugestimmt werden muss, wodurch meine zeitgesteuerten CI-Aufträge mehrfach ausgefallen sind.
MUSL gegen glibc
Ich selbst bin ein und kann GNU glibc überhaupt nicht ausstehen, für die Entwicklung empfehle ich dir trotzdem x86_64-unknown-linux-gnu. Warum? Weil es schnell ist. Das größte Verkaufsargument von MUSL ist, dass es vollständig statisch gelinkte Binaries erzeugen kann – ohne Abhängigkeit von irgendeiner dynamischen Bibliothek des Systems. Das Kompilat läuft auf jeder beliebigen Linux-Maschine, sobald man es dorthin kopiert, was sich besonders für Container und Embedded eignet. Langsam ist es aber genau wegen dieses statischen Linkens: Der Linker muss alles mit einpacken, und damit fällt in der Link-Phase deutlich mehr Arbeit an als beim dynamischen Linken.
Die gute Nachricht ist jedoch: Wenn du macOS verwendest, musst du dir darüber überhaupt keine Gedanken machen, denn aarch64-apple-darwin ist derzeit die einzige Wahl. macOS unterstützt aufgrund seines Designs keine vollständig statische Verknüpfung, was im Hinblick auf die Kompiliergeschwindigkeit sogar von Vorteil ist. Das Entwicklungsprofil verwendet daher unter Linux GNU libc und unter macOS libSystem; das Veröffentlichungsprofil kann sowohl unter macOS als auch unter Linux musl verwenden. Wegen der von macOS standardmäßig gewählten Linker- und Archivierungswerkzeuge ist lediglich zu beachten, dass möglicherweise .cargo/config.toml konfiguriert werden muss.
[target.x86_64-unknown-linux-musl]
linker = "x86_64-linux-musl-gcc"
ar = "x86_64-linux-musl-ar"
Nebenbei bemerkt: Verwende auf keinen Fall Zig, denn zbuild hat unter Rust Nightly derzeit erhebliche Probleme. Wenn du plattformübergreifend kompilieren musst und der Host Linux x86 ist, empfehle ich cross zusammen mit Docker; das funktioniert sehr gut und bringt vollständige Umgebungen mit. Auch wenn du glibc bevorzugst, ist es eine ausgezeichnete Wahl. Da glibc nur Abwärtskompatibilität gewährleistet, kompiliert man üblicherweise mit der glibc-Version einer Debian-Ausgabe, die zwei Hauptversionen zurückliegt. Andernfalls sorgt eine zu neue glibc dafür, dass das Programm auf sehr vielen Rechnern nicht läuft. Das liegt nicht etwa daran, dass du eine neue Funktion verwendet hättest – es wird einfach die Version in einer Zeichenkette geprüft, um dich zu ärgern. Ist der Host ein Mac, verwende das native rustup-target + cargo build --release
UPX ist etwas Schlechtes
Ein weiterer diskussionswürdiger Punkt ist die Verwendung von UPX. Ich weiß, dass ich gesagt habe, ich möge musl, doch gleichzeitig eine geringe Binärgröße anzustreben, ist eigentlich ziemlich widersprüchlich und klingt nicht gerade schlüssig …
                 ooooo     ooo  ooooooooo.  ooooooo  ooooo
                 `888'     `8'  `888   `Y88. `8888    d8'
                  888       8    888   .d88'   Y888..8P
                  888       8    888ooo88P'     `8888'
                  888       8    888           .8PY888.
                  `88.    .8'    888          d8'  `888b
                    `YbodP'     o888o       o888o  o88888o


                    The Ultimate Packer for eXecutables
   Copyright (c) 1996-2026 Markus Oberhumer, Laszlo Molnar & John Reiser
                           https://upx.github.io
Tatsächlich löst UPX dieses Problem jedoch. UPX komprimiert die Binärdatei und versieht sie mit einem Dekomprimierungsstub; beim Start wird sie zunächst im Arbeitsspeicher entpackt und anschließend ausgeführt. Dadurch lässt sich ihre Größe auf etwa 30–50 % des Originals reduzieren, was einen erheblichen Größenvorteil bietet. Genau deshalb kann die Kombination von UPX mit dynamischer Verknüpfung über GNU glibc allerdings große Probleme verursachen: Dynamisch mit glibc verknüpfte Binärdateien enthalten spezielle Abschnitte und Mechanismen zum dynamischen Laden, deren Strukturen durch die UPX-Komprimierung beschädigt werden können, sodass die dynamischen Bibliotheken zur Laufzeit nicht mehr gefunden werden segment fault. Musl eignet sich dagegen hervorragend für UPX: Die Binärdateien sind ohnehin vollständig statisch verknüpft und intern stabil, weshalb Komprimierung und Dekomprimierung durch UPX sauber funktionieren. Ein zusätzlicher UPX-Schritt in der Release-CI für musl ist daher ein deutliches Plus.
Auch UPX sollte nicht übermäßig eingesetzt werden, denn es eignet sich nur für lang laufende oder selten ausgeführte Aufgaben. Lang laufende Aufgaben passen deshalb gut, weil UPX das Programm beim Start einmal im Arbeitsspeicher entpacken muss; dieser vollautomatische Vorgang verlängert den Kaltstart zwar nur geringfügig, kann auf häufig durchlaufenen Pfaden aber dennoch verheerend sein. Ideal sind daher Aufgaben, die einmal gestartet werden und anschließend dauerhaft im Hintergrund laufen. Ich empfehle jedoch nicht, Pakete lang laufender Dienste in docker-Images blind mit UPX zu versehen: Dabei wird letztlich Arbeitsspeicher gegen Plattenplatz getauscht, was sich überhaupt nicht lohnt, und die Komprimierung der Container-Layer erfüllt bereits denselben Zweck wie UPX, indem sie die Downloadgröße bei der Verteilung reduziert. Empfehlenswerter sind bestimmte CLI-Anwendungen: Sie sparen enorm viel Plattenplatz, die Verzögerung durch das Entpacken beim Start ist nahezu unmerklich, und musl eignet sich von Natur aus für CLIs. Andernfalls müsste ich die AUR-Helfer beim Namen nennen: Dieses in go geschriebene Ding war nicht statisch gelinkt, weshalb yay bei mir einmal unter ArchLinux ausfiel, weil es eine dynamische Bibliothek nicht finden konnte. Da es selbst ein Werkzeug zur Systemverwaltung war, gab es keinen direkten Ausweg; ich musste ein separates LiveISO starten und das System schließlich per chroot retten.
Zusammenfassung
Diese praktischen Einstellungen helfen zwar dabei, Entwicklungs- und Veröffentlichungsprofil schnell auseinanderzuhalten, und ihr Nutzen wird mit wachsendem Projektcode immer deutlicher, dennoch empfehle ich, zusätzlich einen Ablauf für kontinuierliche Integration einzurichten, der einen LLVM-Build mit der stabilen Rust-Version ausführt – am besten zusammen mit all deinen Tests. Dann musst du lokal nicht mehr von der nächtlichen Rust-Version wechseln, wirst nicht von Grenzfällen überrascht, und Probleme werden direkt nach dem Hochladen von der kontinuierlichen Integration abgefangen; derzeit ist das die angenehmste Arbeitsweise für eine gute Entwicklererfahrung. Das war es für diesmal – wenn ich wieder Zeit habe, tüftele ich weiter.